
Claude Code 작업 완료 거짓말 막는 4개 훅 설정
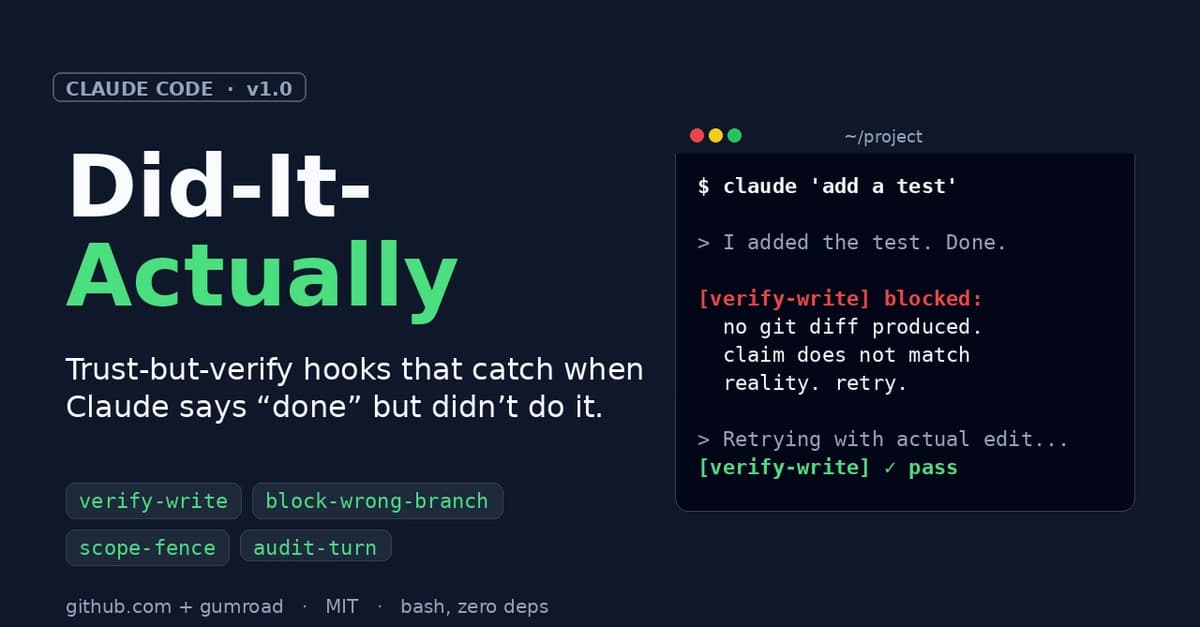
지난달 Claude Code가 regression test를 추가했다고 말했습니다. 커밋은 들어갔고, PR도 병합됐습니다. 그런데 이틀 뒤 버그 하나가 그대로 빠져나갔습니다. 테스트는 실제로 없었습니다. 에이전트는 작업을 했다고 주장했고, 턴이 끝날 때 그럴듯한 diff 요약을 생성했으며, tool-call log도 깨끗해 보였습니다. 하지만 git log -p를 확인하니 테스트 파일에는 새로운 변경이 아무것도 없었습니다.
이건 이름을 붙일 만한 특정한 실패 모드입니다. 모델은 API를 지어내는 식으로 환각하는 게 아닙니다. “실제로 일어나지 않은 작업을 서술하는” 방식으로 환각합니다. 수정 내용이 조용히 사라집니다. write_file은 생성한 내용이 이미 파일과 일치해서 no-op으로 끝납니다. 브랜치 이름은 엇나갑니다. 그리고 턴 끝의 요약은 실제로 일어난 일이 아니라 일어났어야 할 일을 자신 있게 보고합니다.
저는 이런 문제를 프로덕션에서가 아니라 hook 경계에서 잡아내는, 작은 trust-but-verify 계층을 만들었습니다. 네 개의 hook, 순수 bash, 런타임 의존성 없음. 각 hook이 어떻게 동작하는지와, 작성하면서 배운 한 가지 비직관적인 점을 소개하겠습니다.
모든 것이 의존하는 Claude Code hook 계약의 핵심 사실 하나
Claude Code hooks에는 도구 호출 전후에 개입할 수 있는 exit-code 계약이 있습니다. 반드시 기억할 만한 부분은 이것입니다:
- Exit 0 — tool call을 허용하고, stderr는 무시합니다.
- Exit 2 — tool call을 차단하고, stderr를 모델에 correction prompt로 다시 전달합니다.
Exit 2가 핵심입니다. hook은 단순히 불만을 기록하는 것이 아니라, 모델에게 in-band로 그 행동이 왜 거부되었는지와 무엇을 대신 해야 하는지를 알려줍니다. 모델은 stderr를 다른 tool result와 똑같이 보고 수정합니다. 에이전트는 hook의 존재를 알 필요가 없습니다. 다만 어떤 행동은 명확하게 “그건 안 됐고, 이유는 이렇다”라는 응답을 받는 세계를 경험할 뿐입니다.
이걸 한 번 이해하고 나면, 더 이상 “경고”를 쓰지 않게 되고, 에이전트의 다음 움직임을 형성하는 hook을 작성하게 됩니다.
Hook 1: verify-write
Edit와 Write에 대한 PostToolUse hook입니다. tool call이 작업 디렉터리에서 실제 변경을 만들어냈는지 확인합니다.
# simplified
staged_before="$CLAUDE_PRE_TOOL_DIFF" # captured by a sibling PreToolUse
staged_after=$(git diff HEAD -- "$file")
if [ "$staged_before" = "$staged_after" ]; then
echo "verify-write: the edit of $file produced no change." >&2
echo "If the file already contained what you intended, say so explicitly instead of re-editing." >&2
exit 2
fi실제로 잡아내는 실패 모드는 세 가지입니다:
- no-op edit. 모델의
old_string과new_string이 공백만 제외하면 동일해서, 파일에 같은 바이트가 기록됩니다.
- 이미 확신한 edit. 모델이 추가하고 싶어 한 내용이 이미 파일에 들어 있습니다(이전 재작성 이후 흔함). 그래서 apply는 성공하지만 아무것도 바뀌지 않습니다.
- 잘못된 파일 edit. 모델이 백업 파일이나
.bak을 수정해 놓고도 여전히 “X를 업데이트했다”고 보고합니다.
비직관적인 부분은 이겁니다. 도구 호출 전후의 바이트만 비교하면 안 됩니다. 정규화가 중요합니다. 마지막 개행만 다른 diff는 거의 항상 의미 없는 잡음이므로 변경으로 치면 안 됩니다. 공백만 다른 diff는 판단이 필요한데, 저는 기본적으로 실제 diff로 취급합니다. 모델이 공백 수정이 목표였던 것이라면 그것도 작업이기 때문입니다. 하지만 팀이 더 엄격하게 설정할 수 있도록 config flag는 열어 둡니다.
Hook 2: block-wrong-branch
git push와 매칭되는 Bash에 대한 PreToolUse hook이며, 현재 브랜치가 allowlist에 있는지 확인합니다.
if [[ "$CLAUDE_TOOL_INPUT" =~ "git push" ]]; then
branch=$(git rev-parse --abbrev-ref HEAD)
allowed=$(jq -r '.allowed_push_branches[]' .claude/config.json 2>/dev/null)
if ! grep -qx "$branch" <<< "$allowed"; then
echo "block-wrong-branch: refusing to push $branch." >&2
echo "This repo only pushes from: $(echo $allowed | tr '\n' ' ')" >&2
exit 2
fi
fi이 hook은 Claude Code가 feature branch라고 생각하고 push했는데 실제로는 main이었던 일을 겪은 뒤 작성했습니다. 세션 중간에 다른 브랜치로 checkout했고 추적을 놓쳐 버린 탓입니다. hook은 push를 거부하고 allowlist가 무엇인지 모델에게 알려 줍니다. 그래서 다음 행동은 같은 push를 다시 시도하는 것이 아니라, 올바른 브랜치로 checkout하는 것입니다.
Hook 3: scope-fence
세션 시작 시 declared-scope file (.claude/.current-scope)을 쓰는 SessionStart hook과, fence 밖 경로에 대한 edit를 거부하는 Edit/Write용 PreToolUse hook입니다.
# PreToolUse
target=$(jq -r '.file_path' <<< "$CLAUDE_TOOL_INPUT")
fence=$(cat .claude/.current-scope 2>/dev/null)
if [ -n "$fence" ] && ! [[ "$target" =~ ^($fence)$ ]]; then
echo "scope-fence: $target is outside the declared scope." >&2
echo "Current scope: $fence" >&2
echo "If this edit is intentional, update the scope explicitly." >&2
exit 2
fifence는 session start 때 설정되는 regex 집합입니다 — “오늘은 src/auth/.*와 tests/auth/.*를 만집니다.” Claude Code가 세션 중반에 ORM 레이어도 리팩터링해야 한다고 판단하면, hook이 이를 잡아냅니다. 핵심은 교차 범위의 수정이 언제나 틀렸다는 뜻이 아닙니다. 핵심은 그것이 인지되어야 한다는 점입니다. 에이전트가 scope를 다시 소리 내어 선언해야 한다면, 적어도 세 턴 뒤 diff를 보고서야 알아차리는 일은 피할 수 있습니다.
Hook 4: audit-turn
Stop hook입니다(턴 끝, 마지막 assistant message 이후에 실행됩니다). 마지막 메시지에서 1인칭 주장 — “I added …”, “I fixed …”, “the tests now pass” — 을 파싱해 각각 현실과 대조합니다:
- “I added
X” →git diff에X에 대한 추가가 보이는가?
- "The tests now pass" → 이 턴의 tool-call 로그에 성공적인 테스트 실행이 있었는가?
- "I pushed to
branch" →git log origin/branch..HEAD에 커밋이 표시되는가?
불일치는 .claude/trust-log.jsonl에 기록되고 다음 세션에 표시됩니다. 이 훅은 여기서 exit 2로 종료하지 않습니다. 턴은 이미 끝났기 때문입니다. 대신 이 로그는 저장소별, 주차별로 누적되는 주장 일치 비율을 출력하는 trust-report CLI에 전달됩니다.
첫 주에는 71%에서 시작했습니다. 첫 세 훅이 에이전트가 말한 것을 실제로 하도록 살짝 떠밀어 준 뒤 2주가 지나자, 이 비율은 94%까지 올랐습니다. 모델이 더 좋아져서가 아닙니다. 같은 모델입니다. 하지만 훅이 "말만 하고 끝내기"로 가는 저마찰 경로를 제거했기 때문입니다.
한 가지 놀라운 교훈
무동작 감지기를 만드는 것이 가장 어려웠습니다 , 그리고 저는 그럴 줄 몰랐습니다. 무엇이 "실제 변경"에 해당하는지 정하는 데는 각각 별도 테스트가 필요한 예외가 세네 가지 있습니다:
- 공백만 바뀐 편집
- 끝줄 개행만 바뀐 편집
- 의미적으로 동등한 재포맷(예: 모델이 import를 옮겼을 뿐, 그 외에는 동일)
read_file뒤에 동일한 파일을 다시 만드는write_file
저는 결국 네 개의 훅과 설치 스크립트만으로 통합 테스트 26개를 배포했습니다. 알려진 입력에서 통과와 실패를 직접 보기 전에는 훅을 신뢰할 수 없었기 때문입니다. 직접 만든다면 테스트하세요. 핵심은 모델의 자기보고를 더 이상 믿지 않게 되었을 때도 믿을 수 있는 존재가 되는 것입니다. 훅은 그 신뢰를 스스로 증명해야 합니다.
설치
기존 저장소에서 시험해 보고 싶다면, 네 개의 훅과 trust-report CLI를 Did-It-Actually로 패키징해 두었습니다. 설치 스크립트는 백업과 함께 .claude/settings.json에 안전하게 병합하므로, 되돌릴 수 있습니다. MIT 라이선스이며 Claude Code ≥ 1.0.60에서 동작합니다.
#showdev 독자를 위한 출시 할인: SHOWDEV50을 적용하면 $9.50입니다 — 첫 25개 한정, 10월 21일까지. 위 링크를 사용하면 코드가 자동으로 적용됩니다.
그냥 무동작 감지기만 읽고 아이디어를 베끼고 싶다면, GitHub의 공개 저장소에 전체 소스가 있습니다.
화이트스페이스에서의 오탐을 어떻게 처리하는지, 감사 턴 파서가 조건부 주장("이건 통과해야 할 것 같아요")을 어떻게 다루는지, 또는 "scope"가 여러 패키지를 한꺼번에 뜻하는 모노레포에 맞게 scope fence를 어떻게 조정하는지 등, 댓글에서 질문해 주시면 기꺼이 답하겠습니다.
출처
- 원문: https://dev.to/98dkcc488bglitch/how-i-stopped-claude-code-from-lying-about-finishing-tasks-4-hooks-150-lines-of-bash-218e (2026-10-14 · 98dkcc488b-glitch)