
AI 에이전트의 상태 저장과 무상태 설계
상태란 AI 에이전트가 작업 간에 이어서 가져가는 정보이며, 대화 기록부터 장기 기억, 사용자 프로필까지 포함합니다. 상태 저장형 아키텍처와 무상태형 아키텍처 중 무엇을 선택하느냐에 따라 에이전트형 워크플로가 규모를 처리하고 장애에서 복구하는 방식이 달라집니다. 이는 시스템 전체의 신뢰성과 성능에 영향을 미치는 핵심 설계 결정입니다.
상태 저장형 vs. 무상태형: 핵심 개념
상태 저장형 아키텍처와 무상태형 아키텍처의 차이는 상호작용 사이에 정보가 어떻게 처리되는지에 달려 있습니다. 시스템이 이전 상호작용에서 일어난 일을 유지하느냐, 아니면 매 요청을 빈 상태에서 시작하느냐의 문제입니다.
상태 저장형 애플리케이션과 무상태형 애플리케이션을 비교하기 전에, 다음 세 가지 관련 용어를 정의하는 것이 도움이 됩니다.
- State: 쇼핑 카트, 인증 상태, 대화 기록처럼 단일 상호작용을 넘어 지속되는 정보입니다.
- Session: 같은 사용자나 프로세스와 연결된 일련의 관련 상호작용입니다. 시스템이 어떤 상호작용이 함께 묶여야 하는지 판단할 경계를 제공합니다.
- Context: LLM 기반 시스템이 현재 요청을 이해하고 응답하는 데 사용하는 정보입니다. 현재 입력, 이전 상호작용, 저장된 데이터에서 올 수 있습니다.
상태 저장형 애플리케이션
상태 저장형 애플리케이션은 이전 상호작용의 정보를 유지하고, 이를 바탕으로 이후 상호작용을 처리합니다. 그 정보에는 대화 기록, 인증 정보, 장바구니 내용, 다단계 프로세스의 진행 상태 등이 포함될 수 있습니다.
상태 저장의 장점은 연속성입니다. 애플리케이션은 이전 상호작용이 끝난 지점부터 다시 이어서 진행할 수 있습니다. 그 대가로, 해당 상태를 저장하고 관리할 공간이 필요하며, 다음 요청이 도착했을 때 그 상태를 사용할 수 있어야 합니다.
무상태형 애플리케이션
무상태형 애플리케이션은 각 요청을 독립적으로 취급합니다. 즉, 요청을 처리하는 데 필요한 모든 것은 요청과 함께 전달되거나 다른 시스템에서 가져와야 합니다. 이전 요청에 남아 있는 정보를 되돌려 사용하는 일은 없습니다.
무상태형 애플리케이션에서는 인스턴스 간 요청 분산이 더 쉽습니다. 상태를 다른 곳에서 복구할 필요가 없기 때문에 적절한 어떤 인스턴스든 요청을 처리할 수 있습니다. 이는 애플리케이션을 더 확장 가능하고 장애에 강하게 만들 수 있습니다. 하지만 연속성이 중요하다면 시스템 어딘가에 상태를 도입해야 합니다. 그래서 많은 아키텍처가 요청 처리 계층은 무상태형으로 두고, 지속되어야 하는 데이터는 캐시나 다른 공유 시스템에 저장합니다.
💡
현대적인 LLM 앱에도 스크래치패드가 있습니다. 이는 AI 에이전트가 사용자에게 응답하기 전에 중간 결과를 보관하는 임시 저장소입니다. 스크래치패드는 상태 저장형 시스템의 일부가 아니며, 주로 에이전트가 단일 사용자 요청 중에 LLM에 여러 차례 질의를 보내는 동안 정보를 저장하는 데 사용됩니다.
상태 저장형과 무상태형의 주요 차이점
상태 저장형 아키텍처와 무상태형 아키텍처의 실질적인 차이는 정보가 어디에 존재하느냐에서 시작됩니다. 상태 저장형 시스템에서는 애플리케이션이 요청 사이에 정보를 유지합니다. 무상태형 시스템에서는 각 요청이 필요한 내용을 독립적으로 포함하거나 가져옵니다. 이 결정은 시스템의 확장 방식, 장애 복구 방식, 자원 사용 방식에 영향을 줍니다.
| 상태 유지형 | 상태 비유지형 | |
|---|---|---|
| 상태 유지 | 요청이나 세션 간에 정보를 유지함 | 각 요청을 독립적으로 처리함 |
| 확장성 | 트래픽이 인스턴스 사이를 이동해도 상태가 계속 접근 가능해야 함 | 요청을 사용 가능한 인스턴스에 더 자유롭게 분산할 수 있음 |
| 장애 허용성 | 서버가 중단되면 상태가 복제되거나 다른 곳에 지속 저장되지 않는 한 상태 접근이 중단될 수 있음 | 다른 서버가 보통 로컬 세션 상태를 복구하지 않고도 다음 요청을 처리할 수 있음 |
| 복잡성과 리소스 | 상태를 저장, 동기화, 복구하기 위한 인프라가 필요함 | 애플리케이션 인스턴스는 더 단순하지만, 영속 데이터에는 외부 상태 저장소가 필요할 수 있음 |
시스템 전체를 상태 저장형이나 무상태형으로 만들 필요는 없습니다. 많은 아키텍처는 확장을 쉽게 하기 위해 연산은 무상태형으로 유지하면서, 지속되어야 하는 상태는 데이터베이스, 캐시, 또는 다른 공유 저장소로 옮깁니다.
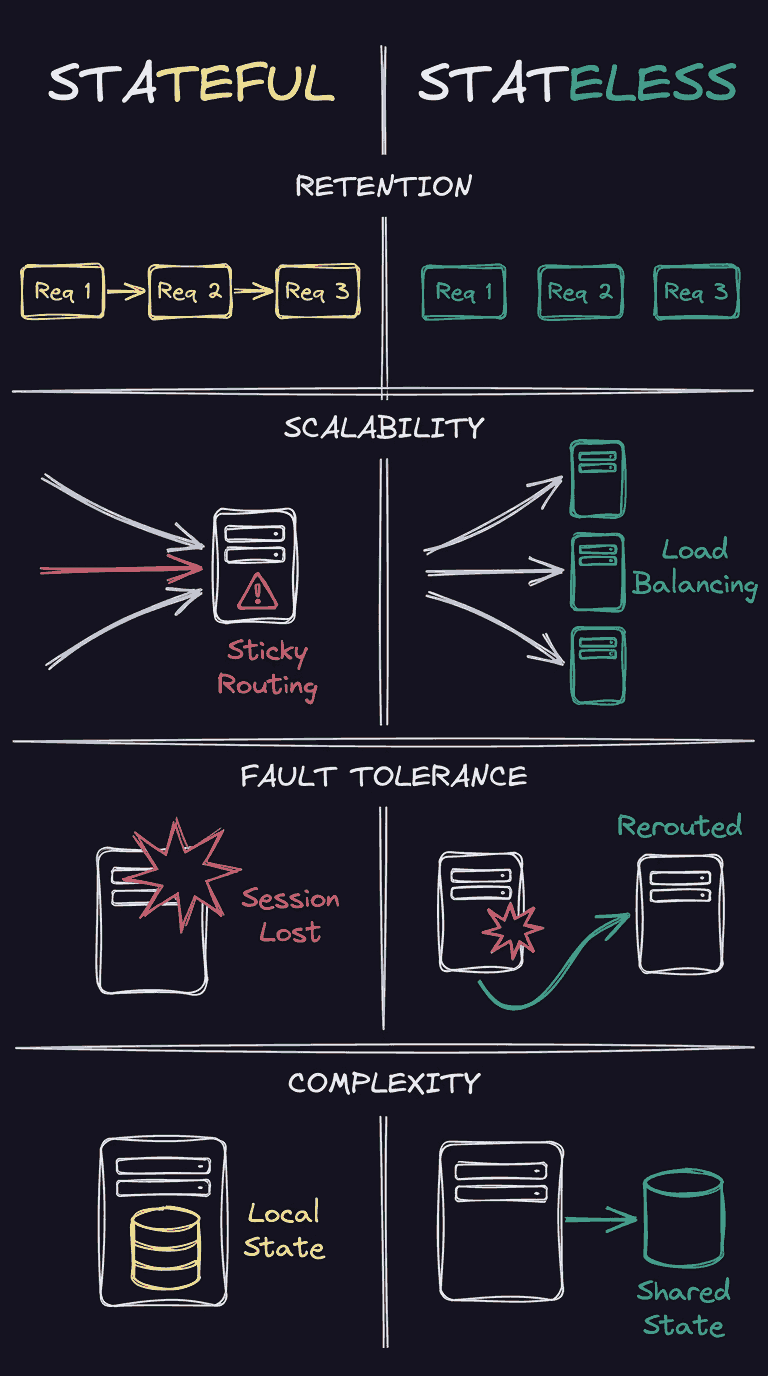
이 개략도는 컨텍스트 유지, 확장성, 장애 허용성, 설정 복잡성이라는 네 가지 핵심 차원에서 상태 저장형 아키텍처와 무상태형 아키텍처의 주요 차이를 보여줍니다
AI 에이전트와 LLM은 상태 저장형인가요, 무상태형인가요?
LLM은 한 추론 요청에서 다음 추론 요청으로 대화를 자동으로 유지하지 않습니다. 애플리케이션이 모델이 이전 메시지를 사용하길 원한다면, 그 메시지들은 모델 입력에 포함되어 전달되거나 시스템의 다른 곳에서 가져와야 합니다.
AI 에이전트는 모델이 이전 상호작용의 정보에 접근할 수 있게 함으로써 상태를 유지하는 방식으로 동작할 수 있습니다. 이것이 메모리가 작동하는 방식입니다. 즉, 에이전트가 모델 바깥에서 상태를 저장하고 검색한 뒤, 관련 컨텍스트를 이후 요청에 추가합니다.
이 상태를 어떻게 저장할지는 얼마나 오래 유지되어야 하는지, 그리고 누가 그 상태에 접근해야 하는지에 따라 달라집니다. 인메모리 버퍼는 세션 내에서 최근 메시지를 보관할 수 있고, 영속 저장소는 단일 프로세스나 재시작을 넘어 그 내용을 보존할 수 있습니다. 분산 시스템에서는 공유 저장소를 통해 여러 지점에서 상태를 사용할 수 있게 할 수 있습니다.
상태 저장형 API와 비상태형 API를 언제 사용할까
확장성과 단순성을 위해서는 비상태형 API를 사용하세요. REST API가 좋은 예입니다. 각 요청에는 인증과 처리를 위해 필요한 정보가 모두 포함되어 있습니다. 비상태형 요청은 여러 인스턴스에 쉽게 분산될 수 있다는 점도 기억하세요. 이는 API가 느려지거나 중단되지 않으면서 용량을 늘려야 할 때 특히 유용합니다.
컨텍스트가 유지되어야 할 때는 상태 저장형 API를 사용하세요. 상태 기반 동작은 대화, 다단계 프로세스, 그리고 다음 단계가 이전에 일어난 일에 따라 달라지는 다른 상호작용에 적합합니다. 이 아키텍처는 세션 쿠키 인증 API, FTP API, 그리고 채팅이나 게임 같은 활동을 위한 실시간 API에 특히 유용합니다.
n8n의 에이전트 상태: Memory 노드 vs. 상태 저장소
n8n은 엔지니어링 팀이 AI 에이전트와 에이전틱 워크플로를 구축할 수 있는 소스 공개형 AI 네이티브 자동화 플랫폼입니다. n8n에서는 유지되어야 하는 내용에 따라 상태를 어디에 둘지 선택할 수 있습니다. AI Agent 노드는 대화 맥락을 위해 Memory 노드를 사용할 수 있고, 상태 저장소는 에이전트 세션을 넘어 유지되어야 하는 데이터를 보관합니다. 이를 통해 전체 워크플로를 상태 저장형으로 만들지 않고도 필요한 곳에만 상태를 추가할 수 있습니다.
기본값은 비상태형
n8n의 워크플로 실행은 서로 독립적입니다. 한 번의 실행이 이전 실행의 데이터를 자동으로 기억하지 않기 때문에, 실행 계층을 더 단순하게 확장하고 복구할 수 있습니다. 워크플로에 연속성이 필요할 때는 적절한 형태의 상태를 명시적으로 추가합니다.
실행 기록은 각 실행을 통해 이동한 데이터도 보여주므로, 상태 기반 동작을 더 쉽게 검토하고 디버그할 수 있습니다.
Memory 노드를 활용한 단기/세션 상태
Memory 노드는 AI 에이전트가 세션 내의 이전 메시지에 접근할 수 있게 해줍니다. Simple Memory 노드는 최근 대화 기록을 위한 인메모리 버퍼를 제공하지만, queue mode와는 호환되지 않습니다.
메모리를 실행 중인 프로세스를 넘어 유지해야 할 때는 Postgres Chat Memory 노드가 영속 저장소를 사용하고 세션 ID별로 대화를 분리합니다. Redis Chat Memory는 워커 간에 세션 상태를 공유할 수 있는 빠른 분산 캐시가 필요할 때 또 다른 선택지를 제공합니다. queue mode에서 분산 실행을 할 때는 세션 상태가 워커 간에 계속 사용 가능하도록 영속 메모리 옵션을 사용하세요. 또한 대화 기록을 더 세밀하게 제어해야 할 때는 Chat Memory Manager를 통해 워크플로가 메시지를 명시적으로 불러오고, 삽입하고, 지울 수 있습니다.
AI Agent Memory에 대한 이러한 접근 방식은 대화의 수명과 규모에 맞게 저장소를 선택할 수 있게 해줍니다. 예를 들어, AI agent chat은 세션 메모리를 사용해 대화가 이어지는 동안 이전 메시지들을 계속 사용할 수 있게 할 수 있습니다.
💡
대부분의 최신 LLM에는 비용을 크게 줄여 주는 캐싱 메커니즘이 있습니다. 슬라이딩 윈도우(즉, 최근 20개 메시지)를 사용하는 메모리 노드를 쓰면 긴 대화 중에 캐시가 무효화됩니다. 슬라이딩 윈도우의 크기를 늘리거나, 단순한 슬라이딩 윈도우 대신 최근 X개 메시지를 요약하는 등 더 고급 기법을 구현할 것을 권장합니다.
상태 저장소를 이용한 내구성 있는 공유 상태
어떤 상태는 대화를 넘어 오래 유지되어야 하거나 워크플로 실행 전반에서 계속 사용 가능해야 합니다. n8n data tables는 워크플로가 실행 간에 읽고 쓸 수 있는 지속적이고 구조화된 저장소를 제공합니다. 사용 사례에 따라 워크플로 static data나 외부 Postgres 또는 Redis 저장소를 사용할 수도 있습니다.
Memory 노드를 상태 저장소와 함께 사용하면 서로 다른 두 가지 상태 계층을 갖게 됩니다. Chat memory 노드는 에이전트의 대화 맥락을 보존하고, 상태 저장소는 데이터 테이블이나 SQL 데이터베이스에 워크플로 및 애플리케이션 데이터를 실행 간에 지속적으로 저장합니다.
먼저 무상태로 만들고, 필요한 곳에만 상태를 추가하세요
상태 기반과 무상태 기반 중 하나를 시스템 전체에서 반드시 선택해야 하는 것은 아닙니다. 가능하다면 독립적인 무상태 실행부터 시작한 다음, 워크플로에 연속성이 필요한 곳에만 상태를 도입하세요.
n8n의 AI 에이전트에서는 진행 중인 대화를 위해 세션 메모리를 추가하거나, 재시작 후에도 맥락이 유지되어야 할 때는 영구 메모리를 추가하거나, 데이터가 여러 워크플로와 실행을 가로질러 전달되어야 할 때는 공유 상태 저장소를 사용하는 것을 의미할 수 있습니다. 적절한 계층을 선택하면 상태가 아키텍처상의 제약이 되는 대신 의도적으로 관리됩니다.
통제 가능한 무상태 기반 위에 상태 기반 동작을 구축하세요. 무료로 시작하기 또는 n8n 템플릿을 살펴보세요.
출처
- 원문: https://blog.n8n.io/stateful-vs-stateless/ (2026-10-22 · n8n team)