
Claude Sonnet 5 공개
좋아요 · 후기 쓰기
이 글의 목차 · 7개 항목
Claude Sonnet 5 공개 및 에이전트 성능 강화
Claude Sonnet 5는 지금까지 나온 Sonnet 모델 중 가장 에이전트적인 모델이 되도록 설계되었습니다. 브라우저와 터미널 같은 도구를 사용하고, 불과 몇 달 전만 해도 더 크고 더 비싼 모델이 필요했던 수준에서 자율적으로 실행할 수 있습니다.
많은 개발자에게 에이전트형 AI 시대는 Sonnet 계열 모델과 함께 시작되었습니다. Claude Sonnet 3.5, 3.6, 3.7은 코딩과 도구 사용에서 인상적인 역량을 보여준 첫 모델들이었습니다. 하지만 더 최근에는 에이전트 능력에서 가장 뚜렷한 향상이 Opus 계열 모델에서 나타났습니다.
Sonnet 5는 그 격차를 줄입니다. 성능은 Opus 4.8에 가깝지만 가격은 더 낮습니다. 추론, 도구 사용, 코딩, 지식 작업 같은 중요한 에이전트 성능 측면에서 이전 모델인 Sonnet 4.6보다 크게 개선되었습니다.
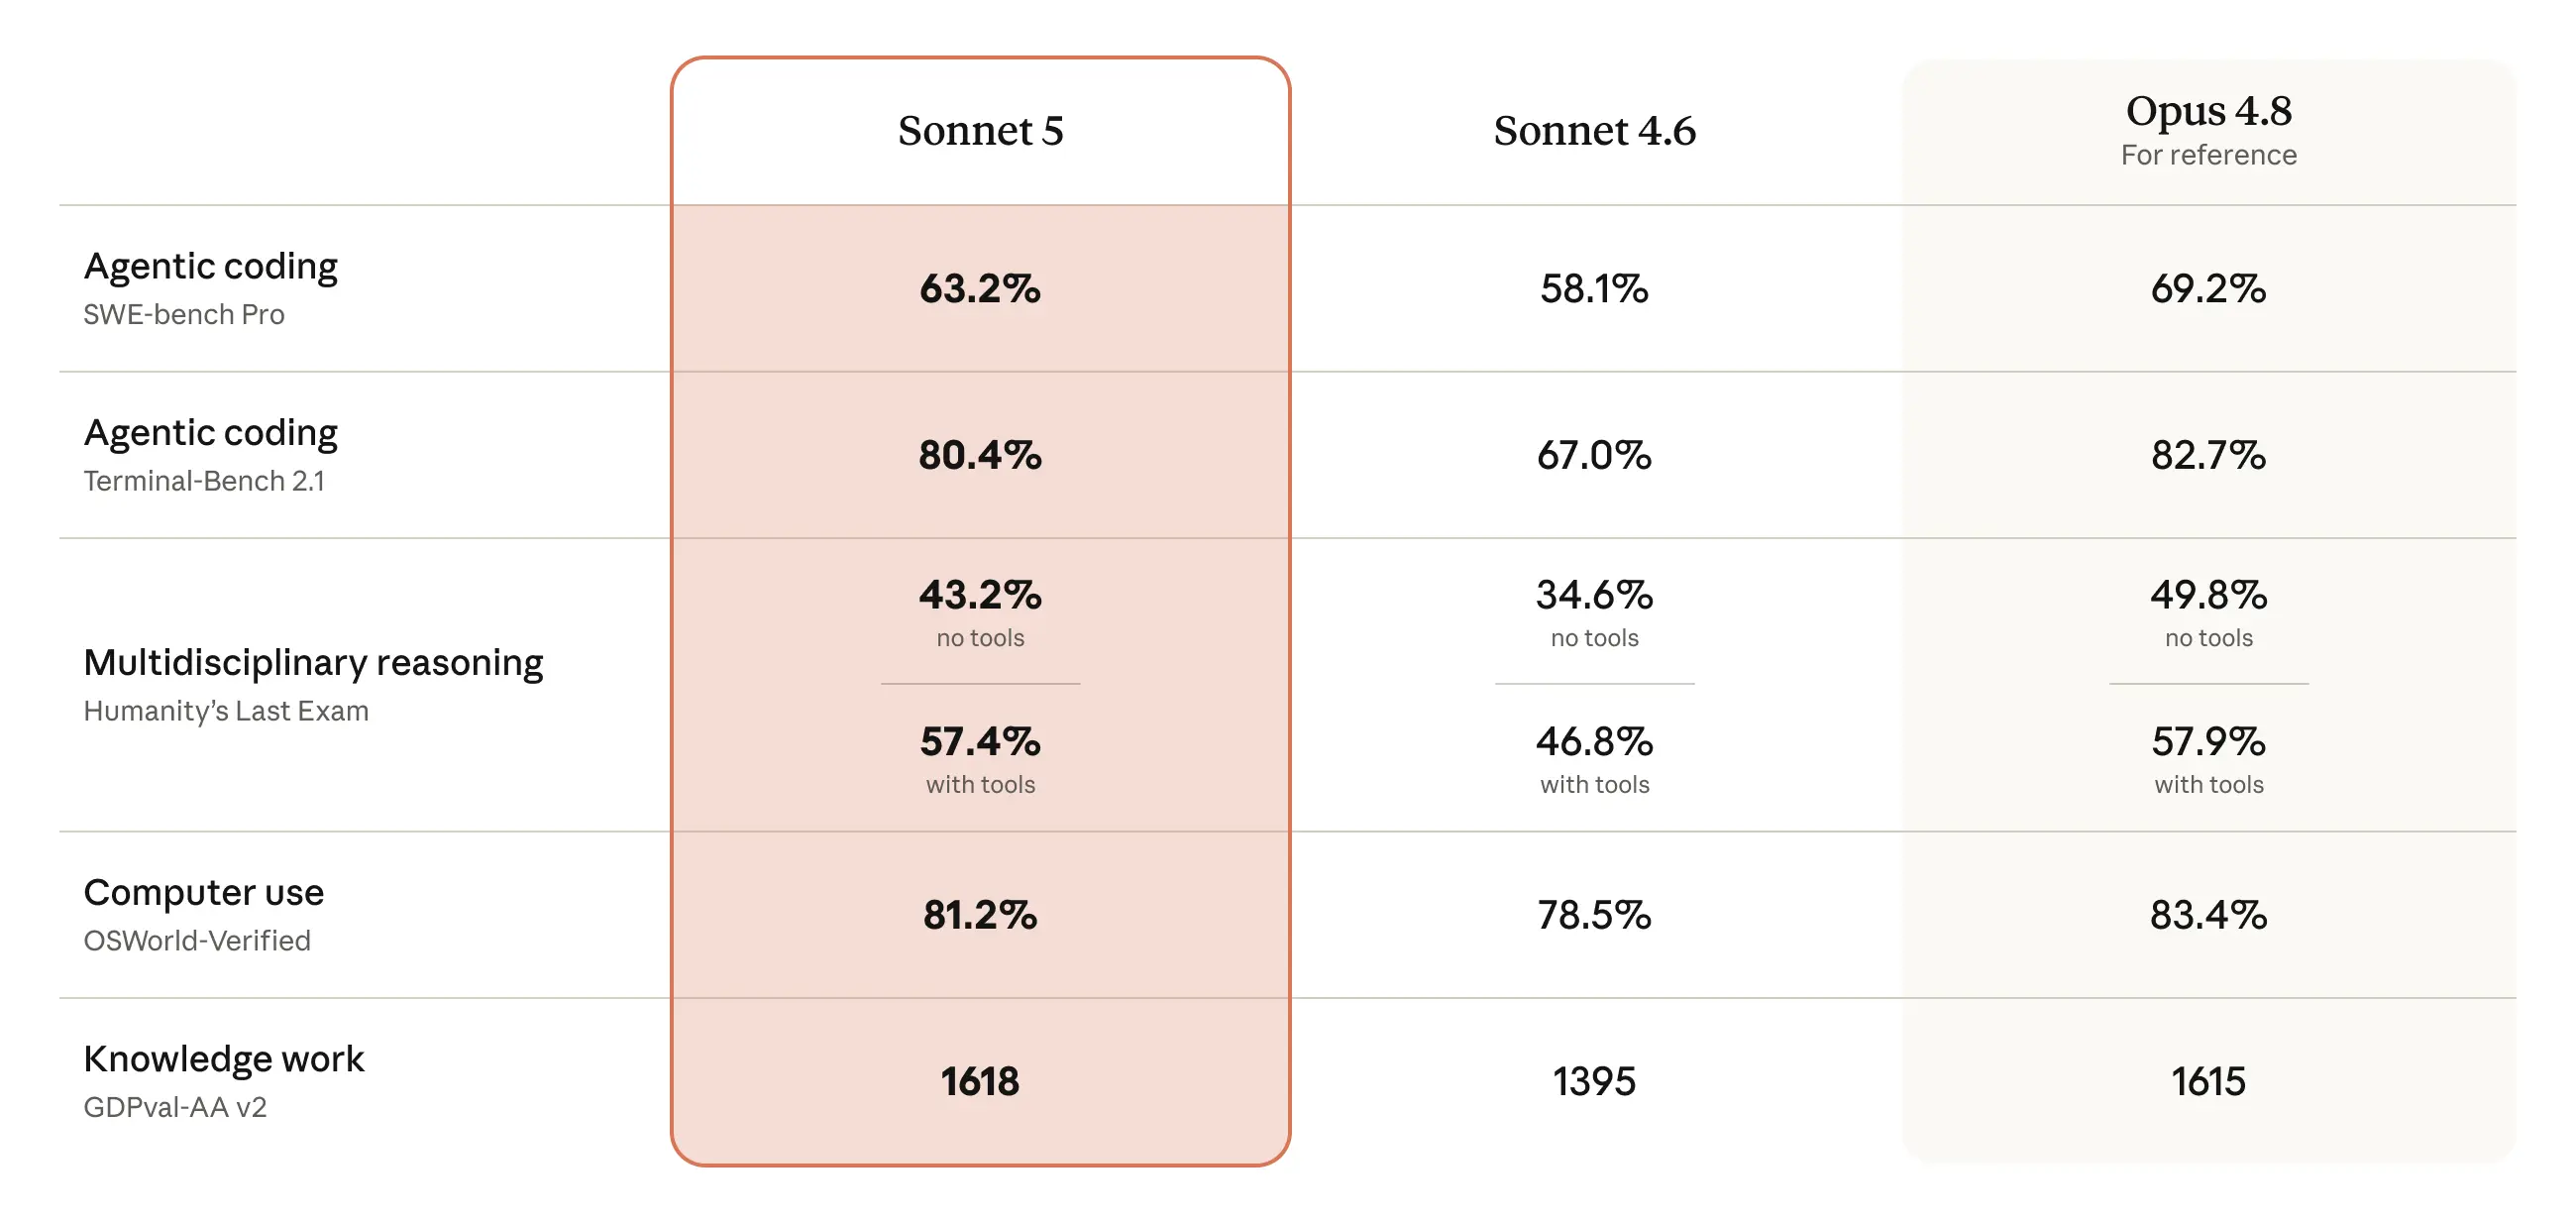
Sonnet 5의 다양한 평가 점수를 Sonnet 4.6 및 Opus 4.8(참고용으로 더 범용적인 역량을 가진 모델)과 비교한 결과입니다. Claude Sonnet 5 System Card에는 더 넓은 범위의 평가가 자세히 보고되어 있습니다.
안전성 평가 결과, Sonnet 5는 Sonnet 4.6보다 바람직하지 않은 행동의 전체 발생률이 더 낮았으며, 에이전트 환경에서 일반적으로 더 안전하게 사용할 수 있는 것으로 나타났습니다. 또한 평가에서는 현재의 Opus 모델들보다 사이버보안 작업을 수행할 능력이 훨씬 낮은 것으로 확인되었습니다.
오늘부터 Claude Sonnet 5는 모든 요금제에서 사용할 수 있습니다. Free 및 Pro 요금제의 기본 모델이며, Max, Team, Enterprise 사용자도 이용할 수 있습니다. 가격은 입력 토큰 100만 개당 \$2, 출력 토큰 100만 개당 \$10입니다. 개발자는 Claude API를 통해 claude-sonnet-5를 사용할 수 있습니다.
Claude Sonnet 5 사용하기
아래 차트는 에이전트형 검색 평가인 BrowseComp와 컴퓨터 사용 평가인 OSWorld-Verified에서 서로 다른 effort 수준별로 Sonnet 5, Sonnet 4.6, Opus 4.8의 성능을 비교합니다. Sonnet 5(주황색 선)는 Sonnet 4.6(회색 선)보다 확실히 우수하며, Opus 4.8(노란색 선)보다 훨씬 더 넓은 비용-성능 선택지를 제공합니다. 중간 effort에서는 비용 효율이 크게 향상되며, 더 높은 effort에서는 일부 작업에서 Opus 4.8과 비슷한 성능을 낼 수 있습니다. Sonnet 5와 Opus 4.8 사이에서는 effort 수준을 조절해 비용과 성능의 균형을 맞출 수 있습니다.
에이전트형 검색
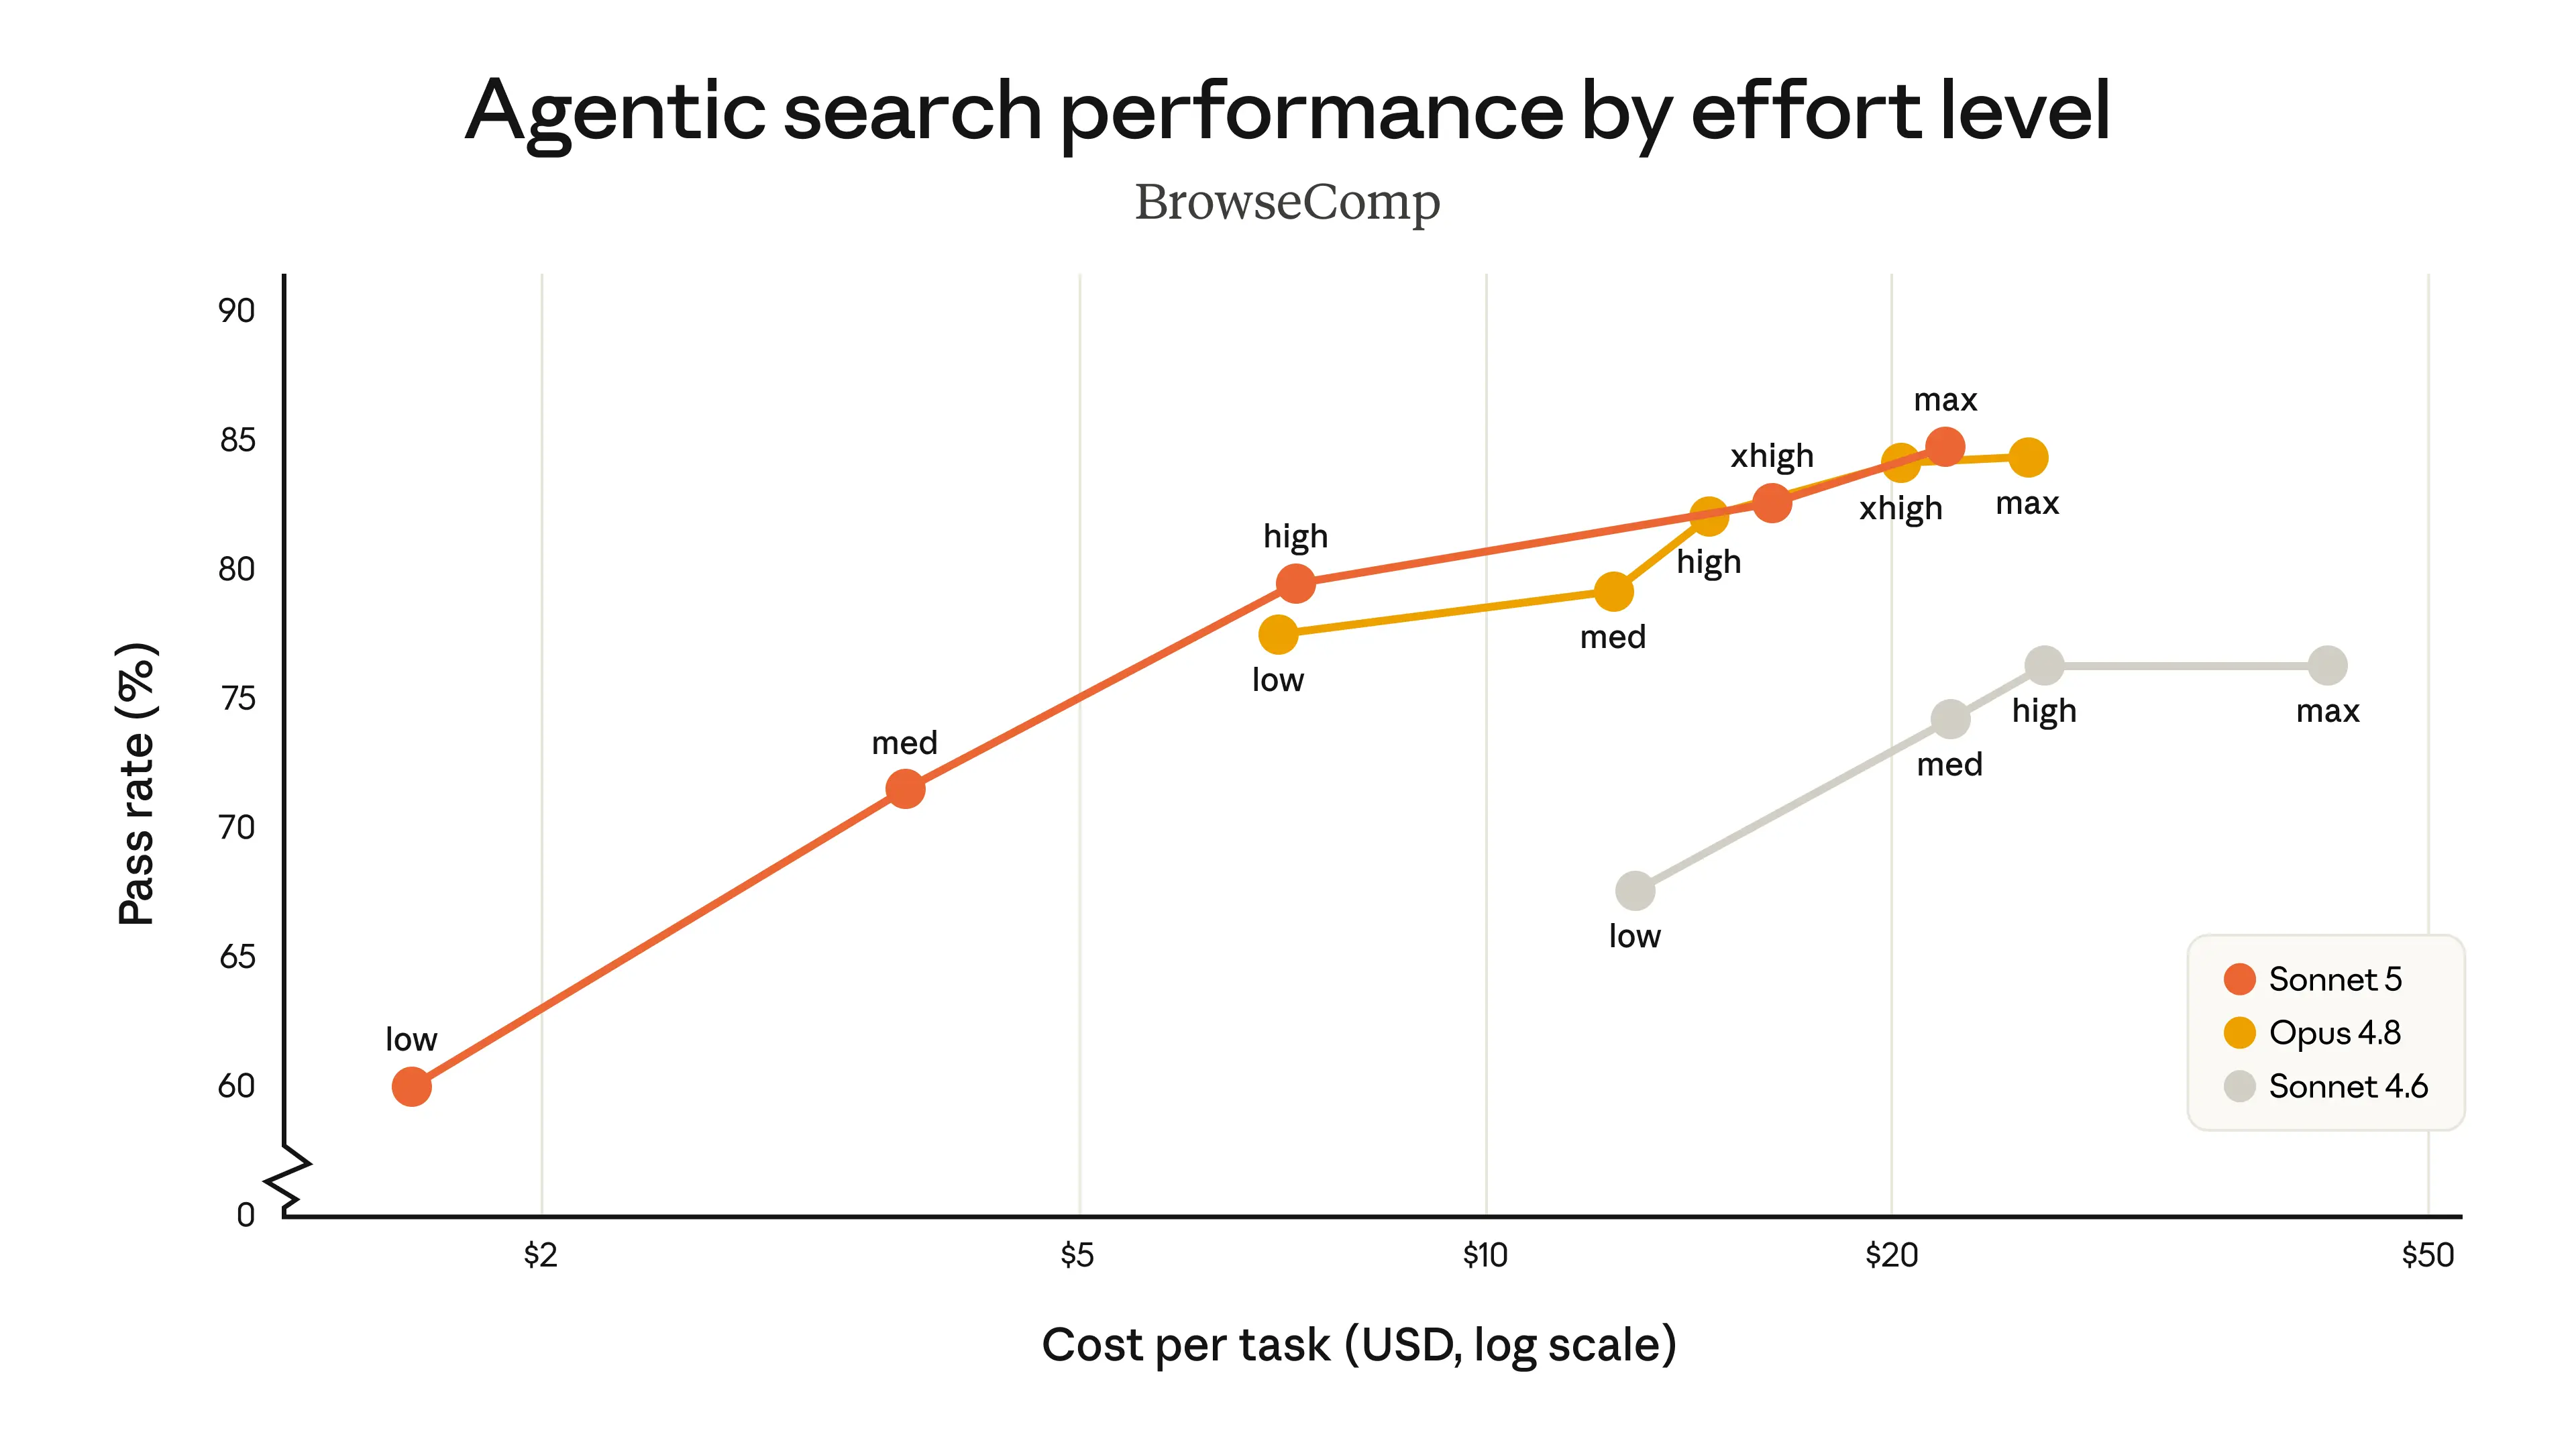
서로 다른 effort 수준에서의 비용-성능 곡선입니다. 이전까지 가장 좋은 Sonnet 모델이었던 Sonnet 4.6은 Opus 4.8에 한참 못 미쳤습니다. Sonnet 5는 Sonnet 4.6보다 더 넓은 비용-성능 선택지를 제공하며, 일부 경우에는 Opus 4.8의 역량 수준과도 일치합니다. 차트에는 Sonnet 5의 가격이 입력 토큰 100만 개당 \$3, 출력 토큰 100만 개당 \$15(기존 표준 가격)로 표시되어 있습니다. Sonnet 5의 도입가인 입력 \$2/MTok, 출력 \$10/MTok은 이후 영구 적용되었으므로 실제 비용은 여기 표시된 것보다 더 낮습니다. Opus 4.8의 가격은 입력 \$5/MTok, 출력 \$25/MTok입니다. xhigh = extra high effort 수준입니다.
에이전트형 컴퓨터 사용
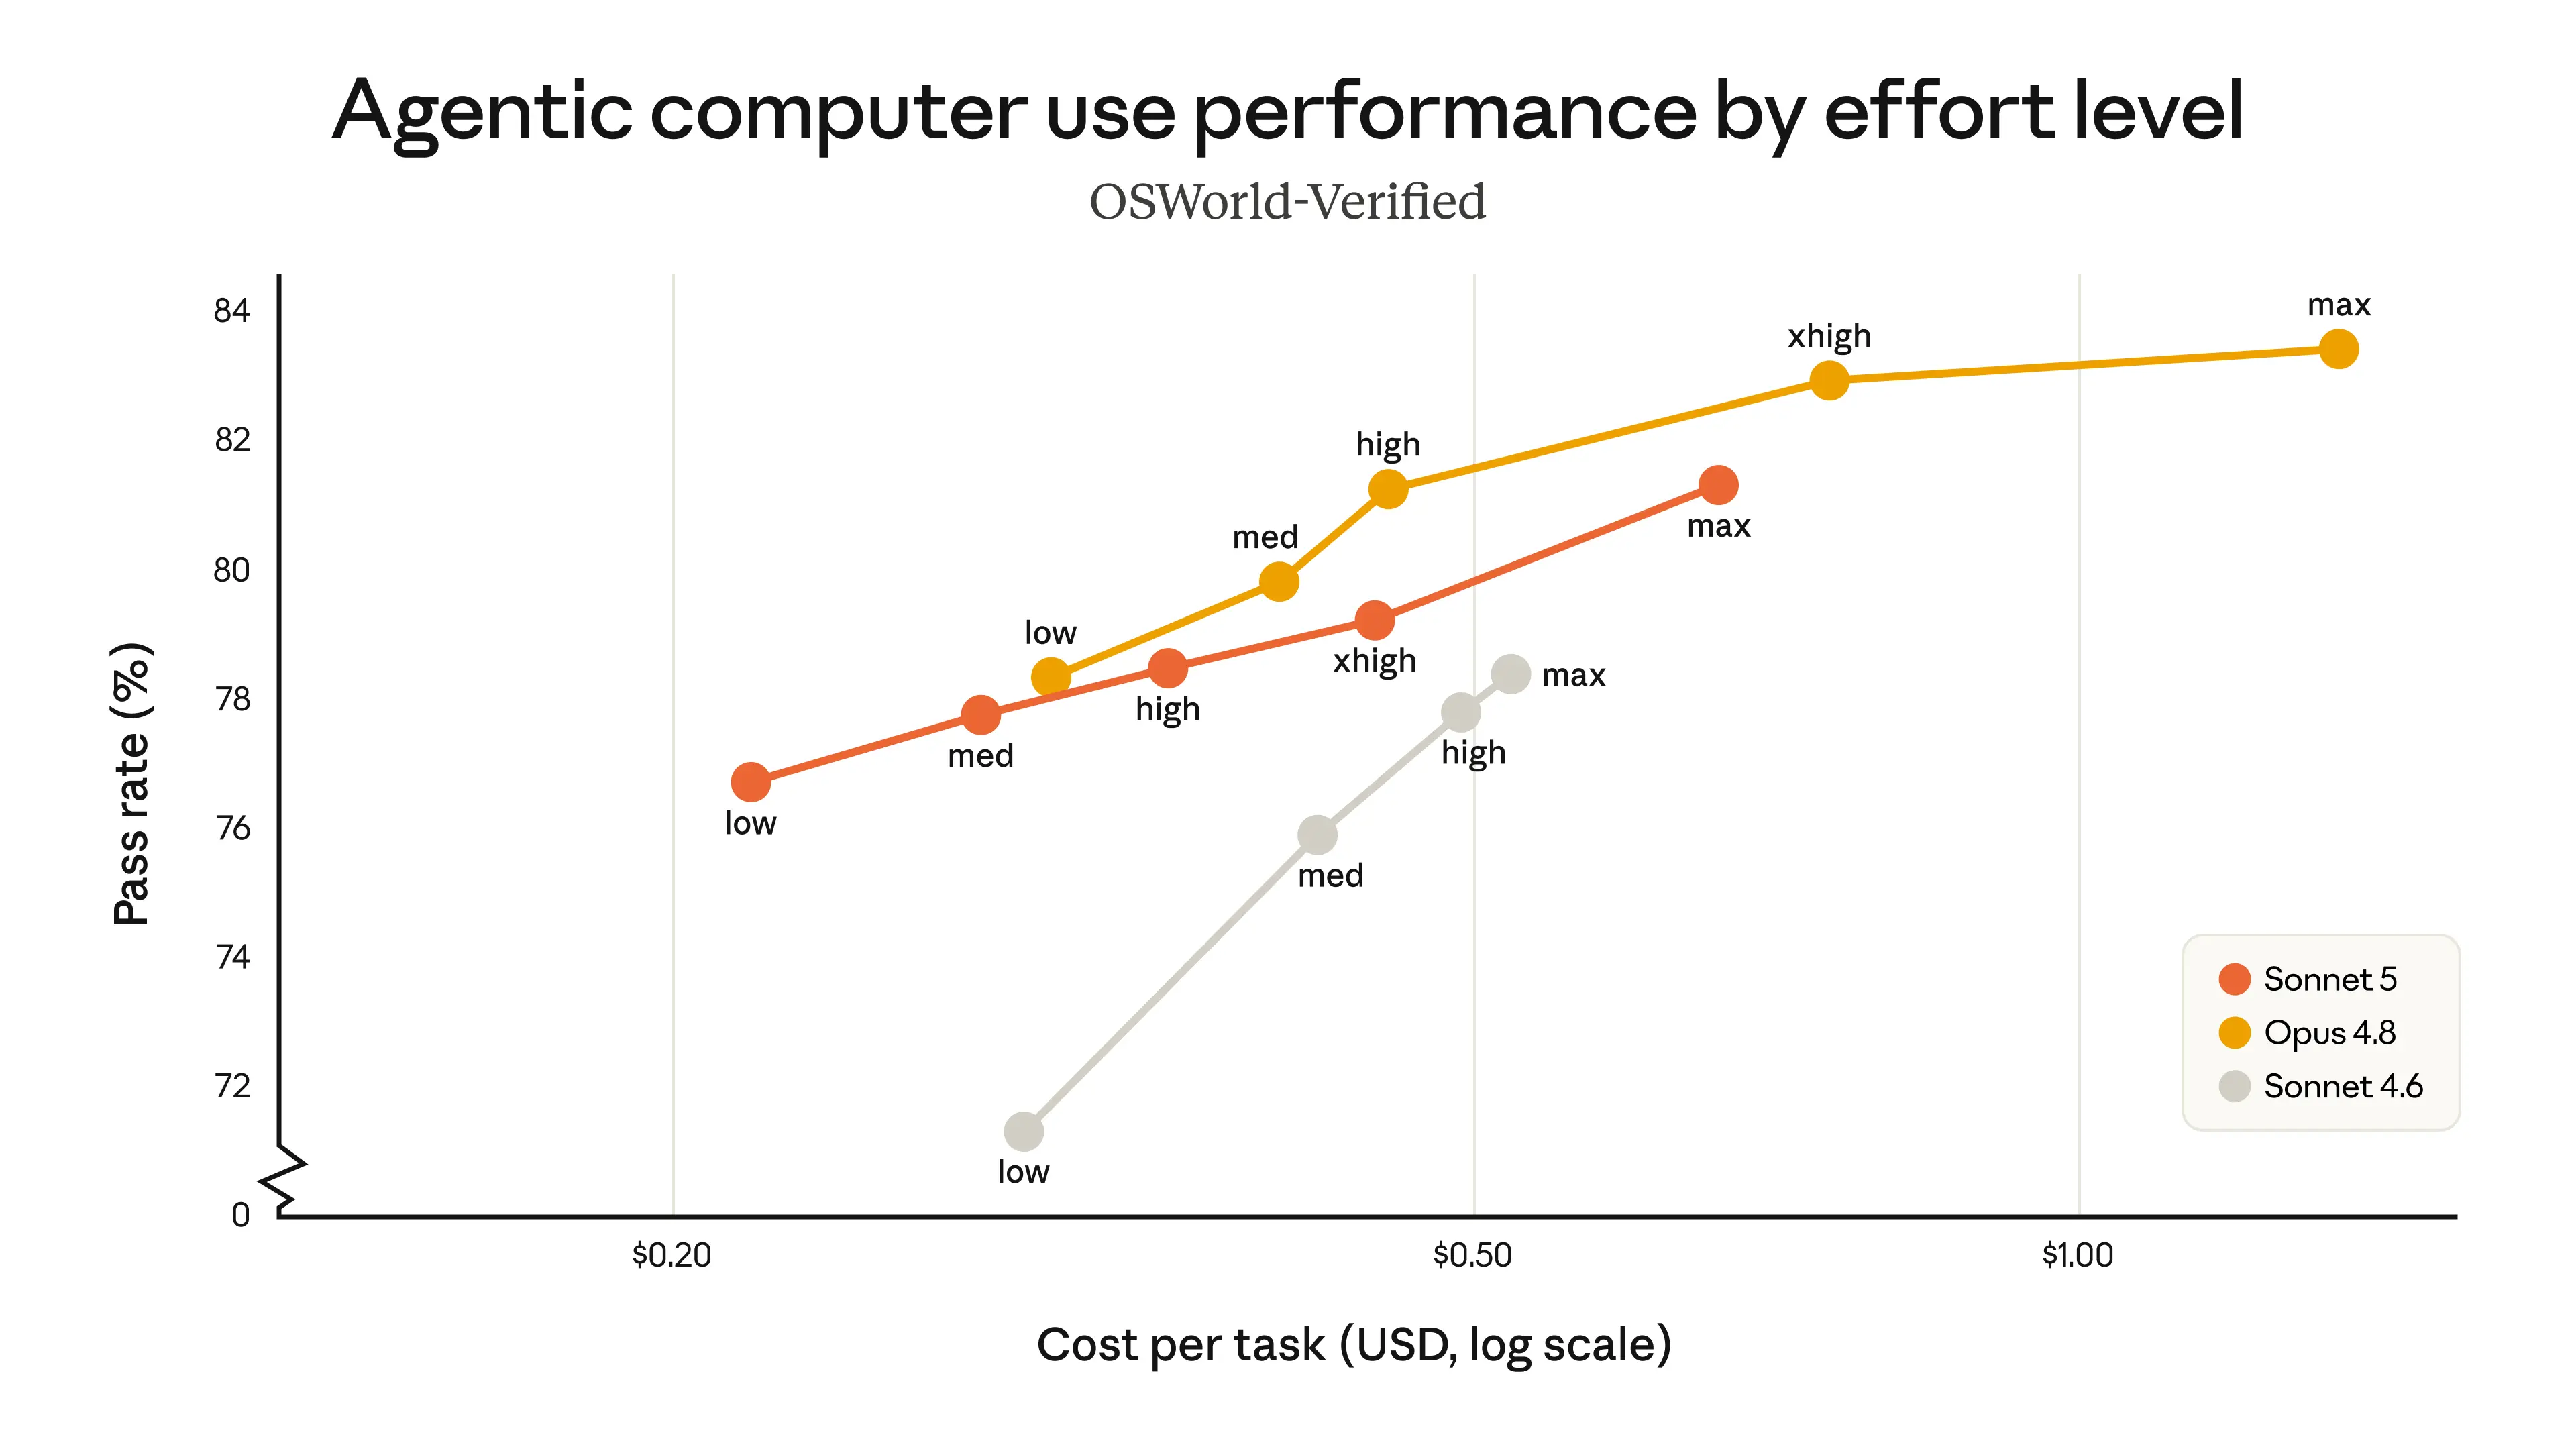
서로 다른 effort 수준에서의 비용-성능 곡선입니다. 이전까지 가장 좋은 Sonnet 모델이었던 Sonnet 4.6은 Opus 4.8에 한참 못 미쳤습니다. Sonnet 5는 Sonnet 4.6보다 더 넓은 비용-성능 선택지를 제공하며, 일부 경우에는 Opus 4.8의 역량 수준과도 일치합니다. 차트에는 Sonnet 5의 가격이 입력 토큰 100만 개당 \$3, 출력 토큰 100만 개당 \$15(기존 표준 가격)로 표시되어 있습니다. Sonnet 5의 도입가인 입력 \$2/MTok, 출력 \$10/MTok은 이후 영구 적용되었으므로 실제 비용은 여기 표시된 것보다 더 낮습니다. Opus 4.8의 가격은 입력 \$5/MTok, 출력 \$25/MTok입니다. xhigh = extra high effort 수준입니다.
초기 액세스 파트너들의 피드백은 일관됐습니다. Sonnet 5는 이전 모델들보다 훨씬 더 에이전틱합니다. 테스트 참가자들은 이전 Sonnet 모델이라면 중간에서 멈췄을 복잡한 작업을 끝까지 마무리하고, 명시적으로 요청받지 않아도 스스로 출력을 검증하며, 이 모든 에이전틱 작업을 매력적인 가격대에서 수행한다고 설명했습니다:
“Claude Sonnet 5는 다단계 소프트웨어 엔지니어링 작업에서 우리 에이전트에 강력한 실행 계층을 제공합니다. 복잡하고 지저분한 기술 환경 전반에서 지속적인 코딩, 도구 사용, 디버깅을 잘 처리하며, 후속 처리와 기술적 기반이 중요한 워크플로에서 특히 유용했습니다.”
Zimu Li
Technical Staff 구성원
“우리는 Claude Sonnet 5에 두 단계 작업을 맡겼습니다. Salesforce 계정 등급을 업데이트하고, 기업 연락처에게 출시 공지를 보내는 일이었죠. 그런데 이 모델은 처음부터 끝까지 모두 해냈습니다. 예전에는 절반쯤에서 멈추곤 했습니다. 일상적인 자동화 용도라면 고민할 필요도 없습니다.”
Daniel Shepard
시니어 엔지니어
“Claude Sonnet 5는 더 적은 것으로 더 많은 일을 해냅니다. 같은 출력 품질을 더 적은 단계로 달성하죠. 또한 안전하지 않은 요청은 깔끔하고 일관되게 거부합니다. Lovable에서는 강력한 도구를 수백만 명의 빌더에게 제공하고 있습니다. 언제 거절해야 하는지 아는 모델은, 어떻게 만들어야 하는지 아는 모델만큼이나 중요합니다.”
Fabian Hedin
공동 창립자
“우리는 Claude Sonnet 5를 가장 까다로운 실제 Pull Request 수십 개에 적용해 봤는데, 각각을 스스로 테스트하고 검증된 결과까지 끝까지 이끌어냈습니다. 덕분에 우리 엔지니어들은 판단, 결정, 최종 승인에 집중할 수 있었습니다.”
Yusuke Kaji
AI for Business 총괄 관리자
“Claude Sonnet 5에게 버그를 조사해 달라고 했습니다. 추가 지시 없이 재현 테스트를 작성하고, 수정 사항을 구현한 다음, 변경 사항이 없을 때 버그가 다시 나타나는지 확인하기 위해 그 변경을 stash했습니다. 모두 단 한 번의 실행으로 끝났습니다.”
Neel Chotai
Rust 엔지니어 및 소프트웨어 엔지니어
“Claude Sonnet 5를 쓰면 에이전트가 계획에서 벗어나지 않고, 우리 규칙을 따르며, 깔끔한 다단계 변경을 효율적인 비용으로 배포합니다.”
Sualeh Asif
공동 창립자
“Claude Sonnet 5는 브라운필드 코드에서 가장 빛납니다. 레이스 컨디션, 숨겨진 테스트, 아무도 손대고 싶어 하지 않는 부분들 말이죠. 증상의 수정이 아니라 실제 근본 원인까지 추적해 내고, 지속 가능한 해결책을 배포합니다.”
Dominic Elm
창립 엔지니어
“Claude Sonnet 5는 Eve의 원고인 측면 작업에서 파레토 최전선에 있습니다. 우리는 법률 조사와 분석에서 가장 뚜렷한 향상을 보았고, 가격 대비 성능 비율이 매우 좋아서 마이그레이션 결정을 쉽게 내릴 수 있었습니다.”
Mauricio Wulfovich
Staff ML Engineer
“ClickHouse 에이전트는 라이브 데이터를 탐색하고 즉석에서 인사이트를 생성하므로, 새 모델을 테스트할 때는 인사이트까지 걸리는 시간이 중요합니다. Claude Sonnet 5는 더 촘촘한 단계로 추론하고, 사용자에게 훨씬 더 빠르게 답을 제공합니다. 그 속도는 고객이 체감하는 차이입니다.”
Ryadh Dahimene
AI/ML 디렉터 PM
“Pace에서는 컴퓨터 사용 에이전트가 보험 워크플로—서류 접수, FNOL, 손해 조사 보고서(loss runs)—를 운영팀이 이미 사용하는 시스템에서 처리합니다. Claude Sonnet 5는 일관되게 올바른 행동을 빠르게 수행하는데, 이것이야말로 실제 보험 업무가 요구하는 바입니다.”
Eric He
Technical Staff 구성원
“대량의 복잡한 워크로드를 관리하는 엔터프라이즈 팀에게 Claude Sonnet 5는 진정한 전진을 의미합니다. 중요한 지점에서 강력한 성능을 보이면서도, 대규모 확장에 실용적인 속도와 비용 구조를 갖췄습니다. 몇몇 복잡한 작업에서는 현재 최전선 모델을 능가하면서도, 낮은 비용으로 빠른 응답을 제공합니다. 대규모로 운영하는 기업에게는 진짜 운영상의 이점입니다.”
Ben Kus
최고기술책임자
“Claude Sonnet 5는 우리가 테스트한 코딩 작업의 전체 범위를 처리하면서도 더 많은 이슈를 해결했습니다. 품질과 효율성 모두에서 의미 있는 개선입니다.”
Manav Khurana
CPMO
“Claude Sonnet 5는 강력한 에이전틱 코딩 모델로, Opus급 모델에 견줄 만한 최상위 정확도를 제공하며 Sonnet 4.6보다 분명한 단계적 향상을 보여줍니다. 철저한 탐색을 수행하고, 복잡한 작업에서 눈에 띄게 더 오래 집중력을 유지합니다.”
Deepak Singh
Kiro 부사장
안전성 평가
출시 전 안전성 평가에서 Sonnet 5는 전반적으로 Sonnet 4.6보다 개선된 것으로 나타났습니다. 에이전트 안전성 측면에서는, 이 모델이 악의적인 요청을 더 잘 거부하고 프롬프트 주입 공격에서 하이재킹 시도에 더 잘 저항합니다. 또한 이 모델은 Sonnet 4.6보다 환각과 아첨의 비율이 더 낮습니다. 다양한 비정렬 행위, 예를 들어 오용에 대한 협조나 기만을 테스트하는 자동화된 행동 감사에서는 Sonnet 5의 점수가 전반적으로 더 낮았습니다(즉, 더 안전했습니다). 다만 이 평가에서는 더 뛰어난 Opus 4.8 및 Claude Mythos Preview에 비해 다소 더 높은 비정렬 행위 비율을 보였습니다.
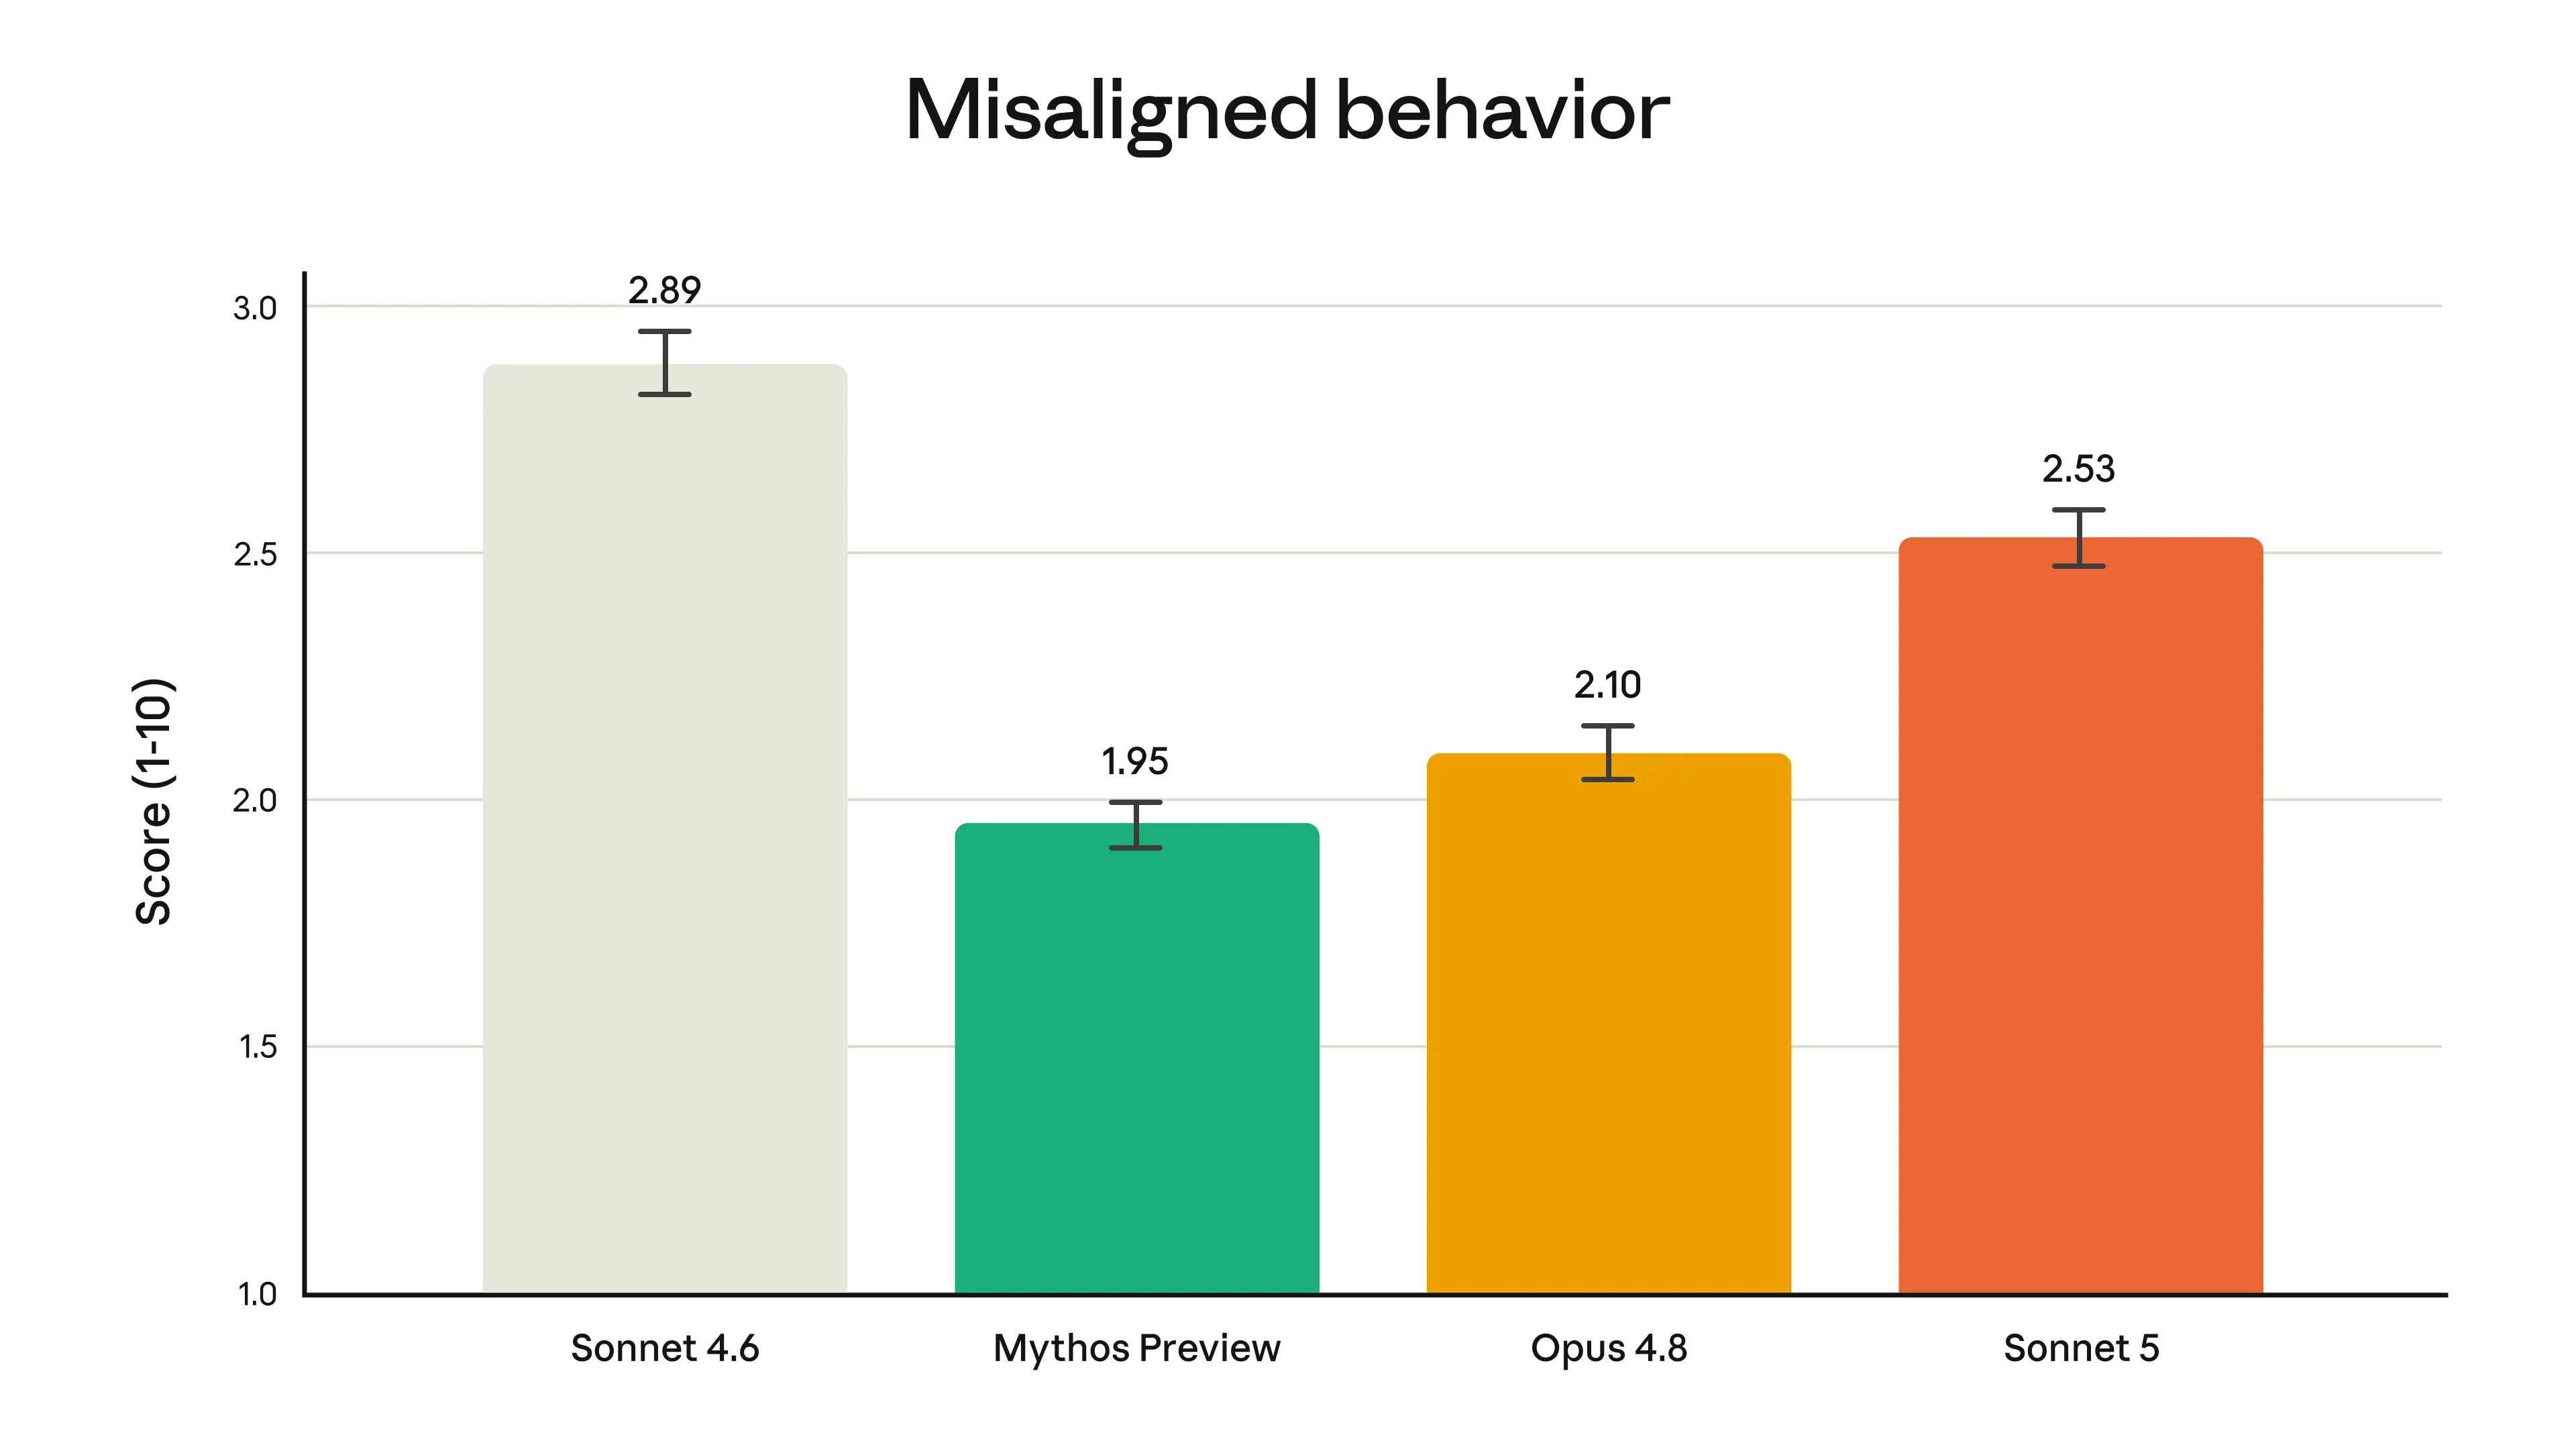
다양한 상황과 맥락에서 매우 광범위한 바람직하지 않은 행동을 테스트하는 자동화된 행동 감사에서의 비정렬 행위 비율입니다. 각 특정 행동에 대한 전체 목록과 결과는 Sonnet 5 System Card의 6.4절을 참조하세요. Sonnet 5는 전반적으로 Sonnet 4.6보다 비정렬 행위 비율이 낮지만, Mythos Preview와 Opus 4.8보다는 높습니다.
우리는 Sonnet 5를 사이버보안 작업에 의도적으로 학습시키지 않았습니다. 이 모델은 일부 일상적이고 무해한 사이버 작업은 수행할 수 있지만, 소프트웨어 익스플로잇 개발처럼 잠재적으로 위험한 사이버 기술을 테스트하는 평가에서는 Opus 4.8 및 Mythos 5와 같은 모델보다 상당히 낮은 성능을 보입니다. 아래 차트는 Firefox 브라우저의 취약점을 악용하는 익스플로잇을 개발하는 능력을 테스트한 한 평가의 점수를 보여줍니다. Sonnet 5는 완전하게 작동하는 익스플로잇을 한 번도 개발하지 못했지만, Sonnet 4.6보다 부분적 성공률이 약간 더 높게 나타났습니다. 이 마지막 변화는 특정 학습보다는 일반 지능의 향상 때문일 가능성이 높습니다.
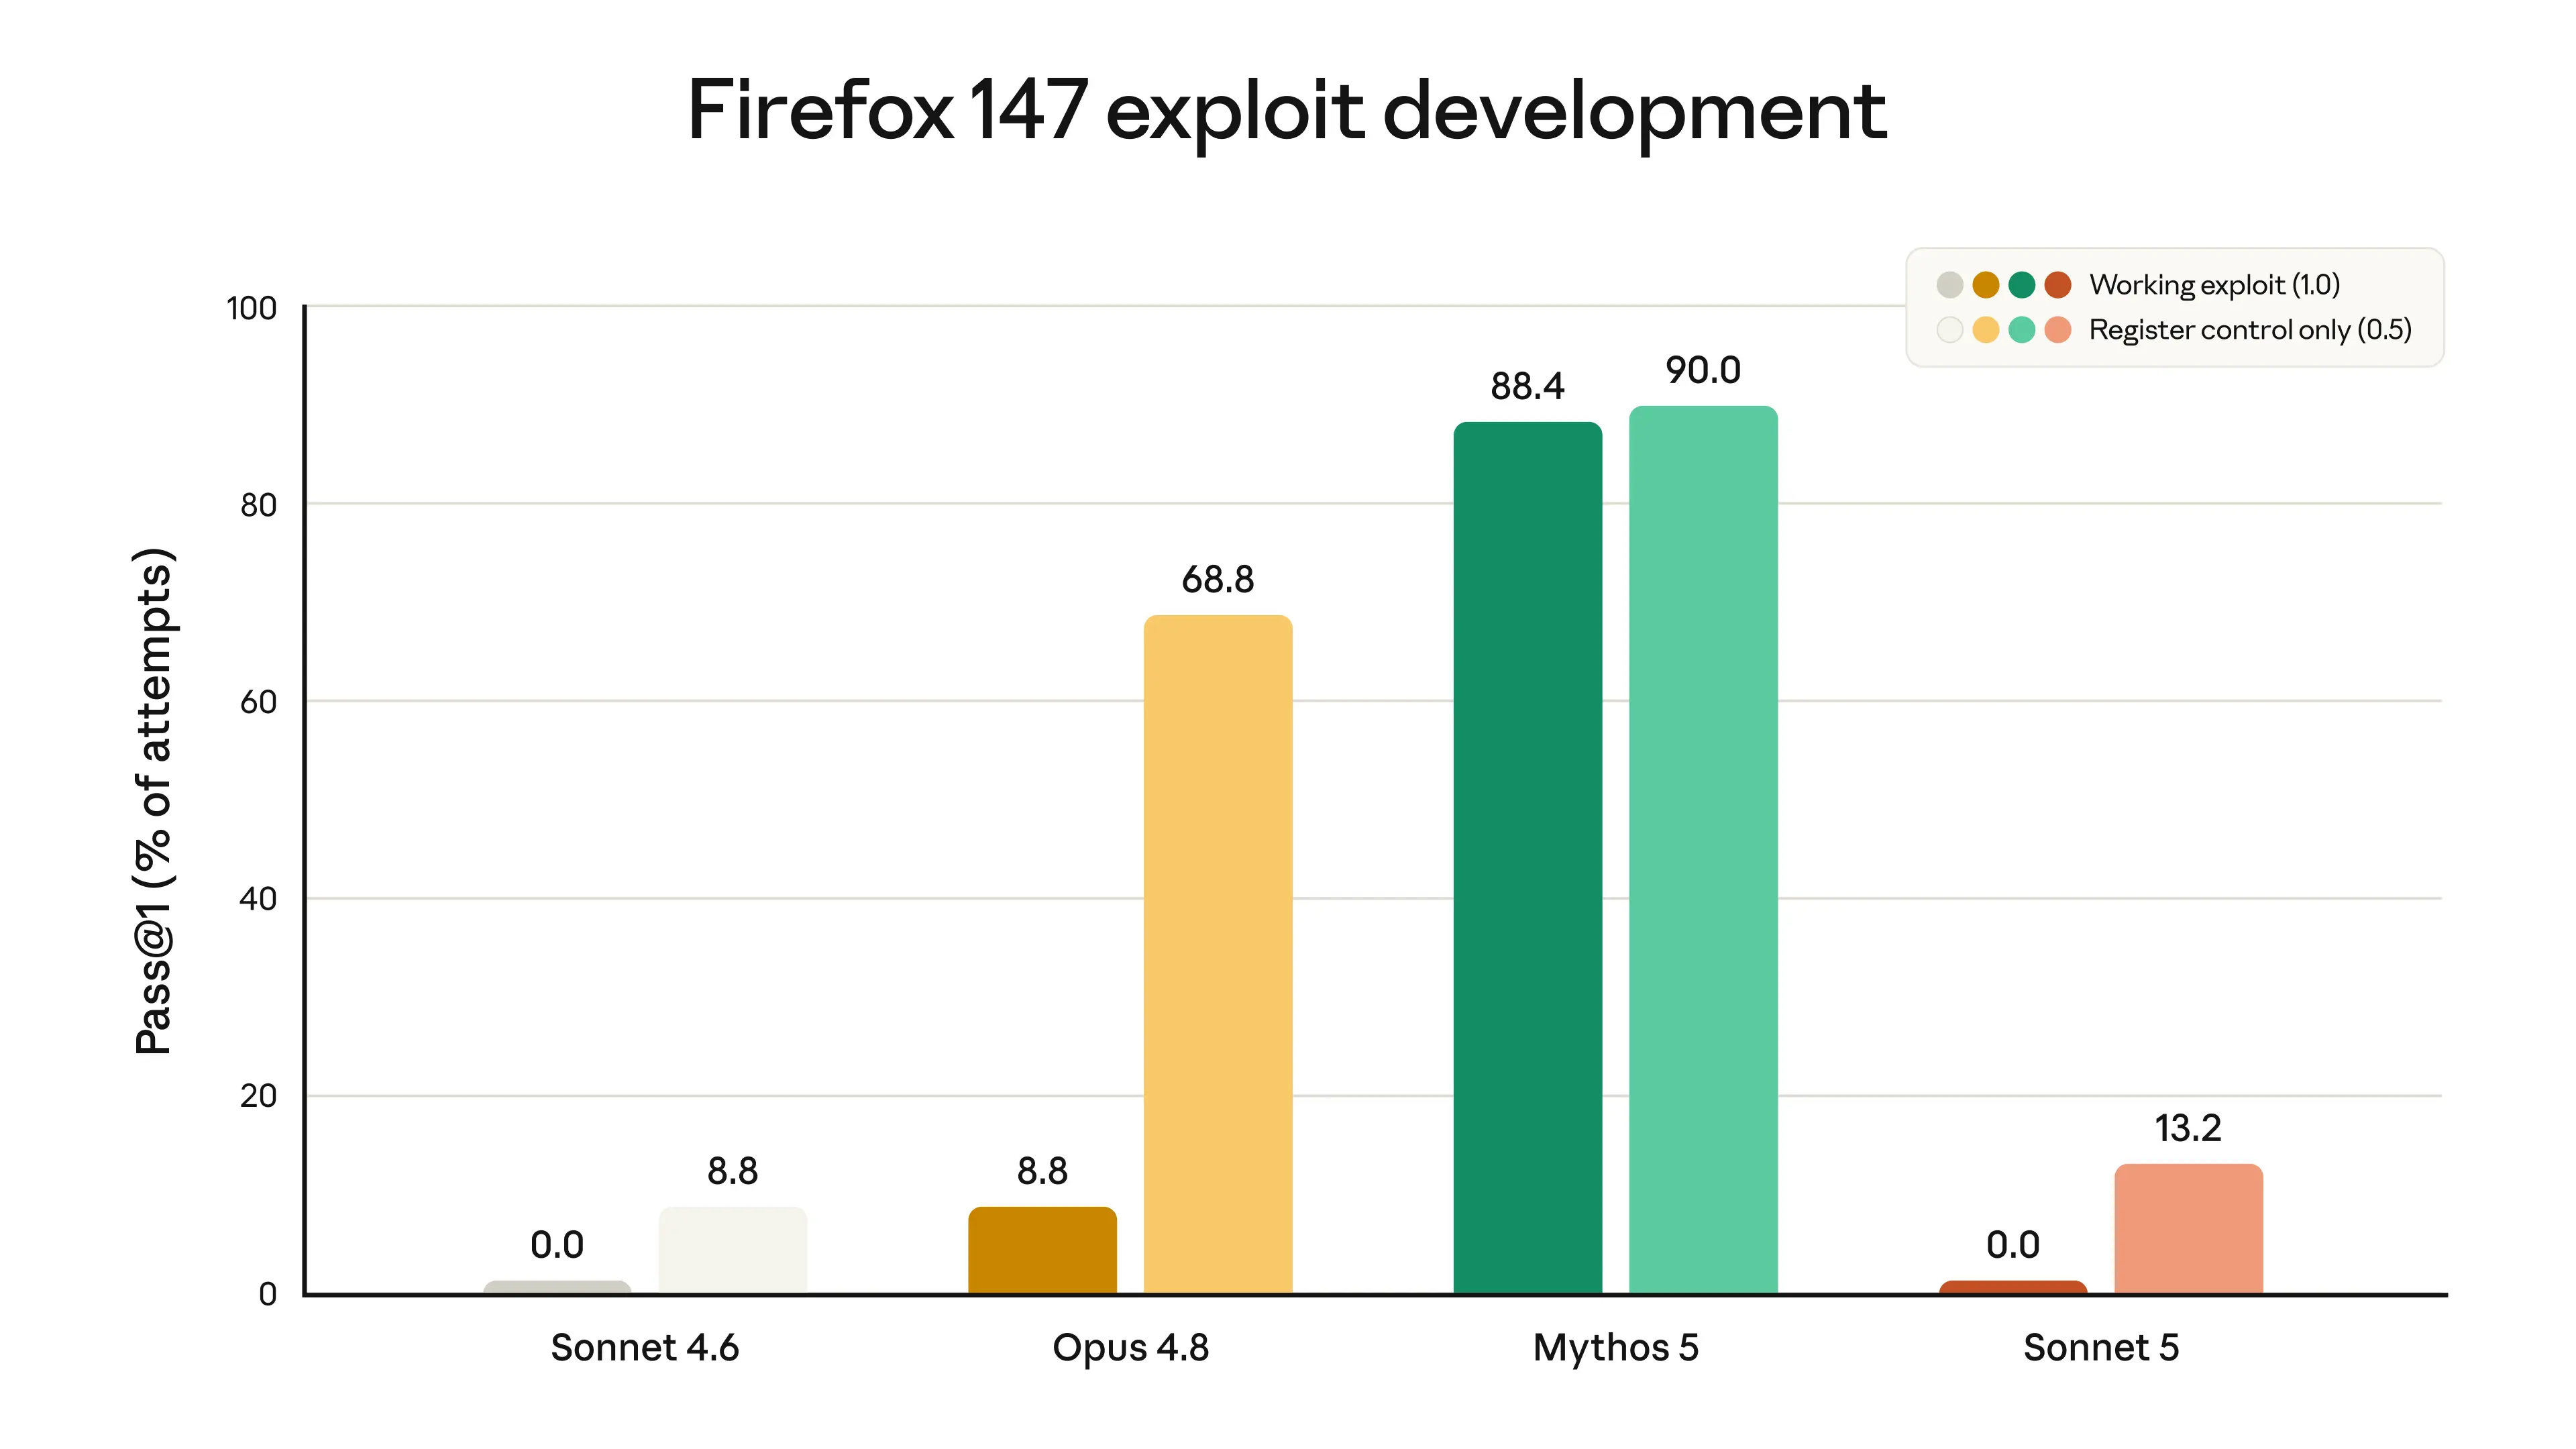
Firefox 147의 소프트웨어 취약점에 대해 모델이 익스플로잇을 개발하는 데 얼마나 성공했는지를 측정한 점수입니다(이 평가는 Mozilla와의 협업으로 개발되었으며, 모든 취약점은 Firefox 148에서 패치되었습니다). 각 모델에서 왼쪽 막대는 모델이(안전장치 없이) 작동하는 익스플로잇을 얼마나 자주 개발했는지를 보여주고, 오른쪽 막대는 부분적으로 성공한 빈도를 보여줍니다. 두 Sonnet 모델 모두 작동하는 익스플로잇을 성공적으로 개발하지 못했으며(둘 다 0.0%를 기록), Sonnet 5는 Sonnet 4.6보다 부분적 성공률이 약간 더 높았습니다. 두 Sonnet 모델의 사이버 역량은 Opus 4.8 및 Mythos 5보다 상당히 낮습니다. 자세한 내용은 Sonnet 5 System Card의 3.2.4절을 참조하세요.
Sonnet 5는 이러한 작업에서 전작보다 다소 강력하기 때문에, 출시 시 기본적으로 사이버 안전장치를 활성화한 상태로 제공됩니다. 이러한 안전장치는 위험한 사이버 사용을 실시간으로 탐지하고 차단하며, Claude Opus 4.7 및 4.8에 적용된 것과 동일합니다(우리는 Sonnet 5의 전반적인 사이버보안 위험 수준이 낮다고 판단했기 때문에, 이 안전장치는 Fable 5와 함께 출시된 것보다 덜 엄격하며, Fable 5에서는 훨씬 더 광범위한 사이버보안 작업을 차단합니다).1
다양한 안전성 및 역량 평가에 걸친 Sonnet 5의 전체 평가는 Claude Sonnet 5 System Card에 보고되어 있습니다.
제공 여부 및 가격
Claude Sonnet 5는 오늘부터 어디서나 입력 토큰 100만 개당 \$2, 출력 토큰 100만 개당 \$10에 이용할 수 있습니다2. 우리는 더 높은 노력 수준에서의 토큰 사용량 증가에 맞추기 위해 Chat, Cowork, Claude Code, 그리고 Claude Platform3의 속도 제한을 상향했습니다. 사용자는 각자의 프로젝트에 맞는 수준을 선택할 수 있습니다.
변경 사항 일지
2026년 8월 10일 수정: Sonnet 5의 소개 가격인 입력 토큰 100만 개당 \$2, 출력 토큰 100만 개당 \$10은 이제 영구 적용됩니다. 이전에 9월 1일부터 적용될 예정이었던 표준 가격인 입력 \$3 / 출력 \$15는 더 이상 적용되지 않습니다. 이 게시물의 가격 관련 표기도 이에 맞게 업데이트했습니다.
2026년 6월 30일 수정: 이 게시물의 원래 버전에는 BrowseComp 평가에 대한 비용 대비 성능 차트가 포함되어 있었는데, 이는 에이전틱 검색 평가에 사용하는 표준 방법론을 반영하지 않는 더 단순한 방법론의 데이터에 기반한 것이었습니다. 그 결과 Sonnet 5의 평가 성능이 실제보다 낮게 추정되었습니다.
이제 우리는 차트를 사용한 방법론과, Sonnet 5 시스템 카드에서 설명한 방법론(컴팩션과 프로그래매틱 도구 호출을 사용한 10M 토큰 예산)을 일치하도록 업데이트했습니다. 또한 주변 문구도 업데이트했습니다.
각주
01 Sonnet 5는 현재 사이버 검증 프로그램의 일부이며, 이 프로그램은 현재 기본 Claude Platform, AWS의 Claude Platform, 그리고 Microsoft Foundry의 Claude(Azure와 Anthropic에서 호스팅)에서 이용할 수 있고, 곧 Google Vertex의 Claude에서도 제공될 예정입니다. 이미 사이버 검증 프로그램에 등록된 조직은 Sonnet 5에서도 동일한 접근 권한을 자동으로 가지며, 다시 신청할 필요가 없습니다. 전반적으로, 가드레일을 줄여야 하는 사이버 보안 작업에는 Claude Opus 4.8을 권장합니다.
02 Sonnet 5는 Sonnet 4.6의 업그레이드 버전이지만, 모델이 텍스트를 처리하는 방식을 바꿔 성능을 개선하는 업데이트된 토크나이저를 사용합니다(이는 우리가 Claude Opus 4.7에서 도입한 토크나이저 변경과 유사합니다). 그 대가로 동일한 입력이 더 많은 토큰으로 매핑될 수 있으며, 콘텐츠 유형에 따라 대략 1.0–1.35배 정도입니다.
03 2026년 4월 26일, 우리는 기본 Claude Platform의 모든 사용량 등급에서 Sonnet과 Haiku의 rate limit을 상향하고, 세 개의 등급(Start, Build, Scale)으로 단순화했습니다. Claude Console에서 현재 등급과 한도를 확인할 수 있으며, 더 자세한 내용은 문서를 참고하세요.
- Humanity’s Last Exam: Humanity’s Last Exam의 채점 모델을 업데이트했으며, 이에 따라 Sonnet 4.6 점수를 34.6%(도구 없음) 및 46.8%(도구 사용)로 수정했습니다. 이것이 Sonnet 4.6 출시 블로그에 보고된 점수와 다른 이유입니다.
- OSWorld-Verified: 모델의 실제 성능을 더 정확히 반영하도록 OSWorld-Verified 평가를 수행하는 방식을 변경했으며, 이에 따라 Sonnet 4.6 점수를 78.5%로 수정했습니다. 이것이 Sonnet 4.6 출시 블로그에 보고된 점수와 다른 이유입니다.
출처
- 원문: https://www.anthropic.com/news/claude-sonnet-5 (2026-10-26 · anthropic.com)
자료 표지 보기
