
Xiaomi MiMo V2.6 Pro RL 공개
| 🤗 HuggingFace | 📰 블로그 | 🎨 Xiaomi MiMo API Platform | 🗨️ Xiaomi MiMo Studio | 💻 Xiaomi MiMo Desktop |
커뮤니티 WeChat Group | Discord | Telegram | Reddit
MiMo-V2.6-Pro-RL
자기 개선을 향한 강화학습의 확장
PDFPDF 파일내려받기1. 소개
MiMo-V2.6-Pro-RL은 MiMo-V2.6 시리즈의 플래그십 체크포인트입니다. 이 시리즈는 자기 개선을 향해 강화학습을 확장하도록 설계되었으며, RL 연산량, 환경 다양성, 채점 연산량을 함께 확장하여 모델이 탐색과 피드백을 통해 능력의 최전선을 계속 넓혀 가도록 합니다. 주요 특징은 다음과 같습니다:
- 네이티브 옴니모달 + 장기 맥락: 텍스트, 이미지, 비디오, 오디오를 하나의 모델에서 지원하며, 긴 저장소, 도구 추적, 다중 세션 에이전트 실행을 위해 1M 토큰을 지원합니다.
- 한 번만 RL: 코딩, 일반 에이전트, 시각, 사이버 보안을 위한 별도 실행이 아니라 하나의 혼합 RL 실행으로 처리합니다. 과제와 여러 하네스를 같은 배치에 섞어, 능력이 서로 강화되고 훈련에서 보지 못한 하네스로도 전략이 전이되도록 합니다.
- RL 연산량 확장: 매우 큰 배치에서 완전 비동기식 Group Relative Policy Optimization(GRPO)을 사용합니다 — 한 단계당 1,568개의 프롬프트 × 각 프롬프트당 16회 롤아웃, 업데이트마다 수십억 토큰 규모입니다.
- 그룹 단위 에이전틱 채점(자기 개선 루프): 이진 합격/불합격만으로는 합격한 해답들 사이의 순위를 매길 수 없으므로, 보상 신호 자체를 확장합니다. 에이전틱 채점기는 각 그룹 안에서 롤아웃을 서로 비교합니다. Groupwise Reward Synthesis(GRS)는 대조되는 롤아웃으로부터 과제별 루브릭을 오프라인으로 구축하고, 루브릭 품질과 테스트 결과를 결합합니다. Groupwise Advantage Redistribution(GAR)는 합격 궤적을 온라인으로 순위화하고, 더 높은 품질의 해답 쪽으로 어드밴티지를 이동시킵니다. 정책 자신의 샘플을 기준으로 평가함으로써 자기 개선 루프를 닫고, 더 짧은 경로와 과제당 더 적은 토큰을 향하도록 유도합니다.
- 정렬된 RL: 자기 수정에서 시작하는 콜드 스타트 — 모델이 자신의 정렬되지 않은 발화를 반성하고 이를 근거 있는 다음 단계로 다시 씁니다. RL 전반에서 환경 강화, 적대적 선별, 검증기 교차 검증이 보상 해킹에 맞서 루프의 정직성을 유지합니다.
- Multi-Prefix Multi-Teacher On-Policy Distillation(MOPD2): 혼합 RL 이후, MOPD2는 자율적인 학생 롤아웃과 접두사 조건의 단일 턴 롤아웃(Teacher-Prefix 및 SFT-Prefix)을 결합합니다. 교사 궤적과 SFT 시연에서 히스토리를 재사용하여, 이전 턴을 다시 생성하지 않고도 의사결정 지점을 학습시킵니다. 이를 통해 검증하기 어려운 과제까지 능력을 확장합니다.
모델 요약
- Architecture: Sparse MoE(Mixture of Experts), 총 1.02T / 활성화 파라미터 42B
- Context Length: 1M 토큰
- Modalities: Text, Image, Video, Audio
- Vision Encoder: 681M 파라미터 MiMo ViT(28개 레이어: 24 SWA + 4 Full)
- Audio Encoder: 308M AudioTokenizer + 127M 오디오 패치 인코더
- Multi-Token Prediction (MTP): 5개 레이어의 speculative decoder

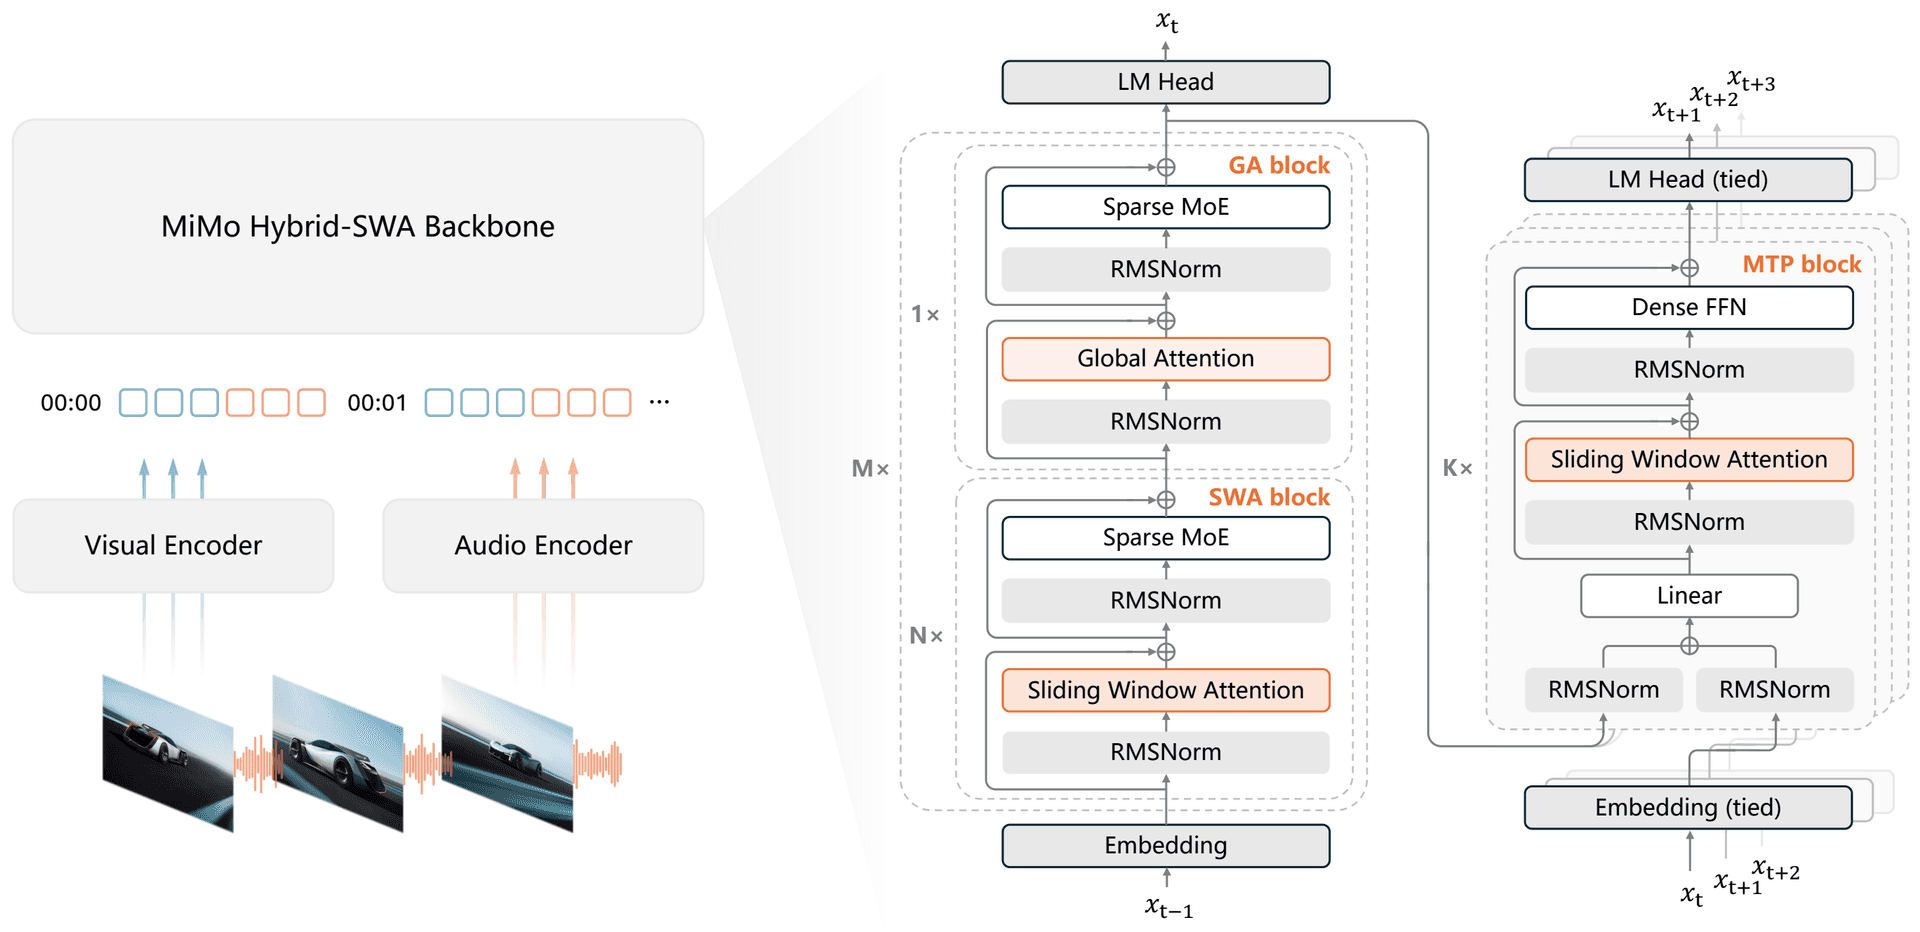
그림 1. MiMo-V2.6 architecture.
2. 다운로드
| 모델 | 다운로드 |
|---|---|
| MiMo-V2.6-Pro-RL | 🤗 HuggingFace · 🤖 ModelScope |
| MiMo-V2.6-Flash-RL | 🤗 HuggingFace · 🤖 ModelScope |
3. 평가 결과
| 벤치마크 | MiMo-V2.6 Pro | MiMo-V2.6 Flash | MiMo-V2.5 Pro | Claude Opus 5 | GPT-5.6 Sol | Claude Fable 5 |
|---|---|---|---|---|---|---|
| Code Agent | ||||||
| DeepSWE v1.1 | 71.9 | 67.9 | 19.0 | 74.0 | 73.0 | 70.0 |
| ProgramBench | 26.5 | 26.0 | 12.5 | 37.0 | 25.0 | 33.0 |
| MiMo Code Bench | 63.2 | 61.2 | 40.4 | 68.6 | 59.3 | - |
| General Agent | ||||||
| AutomationBench v1.0.6 | 53.1 | 52.3 | 16.0 | 50.3 | 45.8 | 46.2 |
| Toolathlon-Verified | 76.9 | 73.6 | 49.1 | 80.6 | 74.9 | 77.9 |
| GDPval-AA 2.1 | 1673 | - | 1107 | 1708 | 1588 | 1595 |
| Agents’ Last Exam | 31.6 | 27.6 | 13.2 | 31.6 | 30.8 | 25.7 |
| Terminal Bench 4.0 | 34.9 | 28.8 | 1.5 | 49.0 | 39.9 | 42.4 |
| Terminal Bench 2.1 | 89.9 | 87.6 | 65.2 | 89.1 | 88.8 | 84.3 |
| OSWorld-Verified | 82.0 | 80.8 | - | 83.4 | 83.0 | 86.0 |
| JobBench | 62.0 | 61.2 | 25.0 | 65.7 | 45.4 | 57.4 |
| Cybersecurity | ||||||
| CyberGym | 94.0 | 95.1 | 40.0 | - | - | - |
| MiMo Cyber Bench | 80.2 | 77.2 | 0.0 | - | - | - |
| ExploitGym | 17.8 | 6.0 | 0.2 | 22.1 | 30.3 | 28.4 |
| ExploitBench | 47.9 | 25.3 | 16.6 | 70.0 | 78.5 | 78.0 |
| SEC Bench Pro | 66.3 | 47.5 | 17.7 | - | 79.1 | - |
| Visual Agent | ||||||
| MiMo VisualCoding | 72.3 | 71.5 | - | 70.0 | 73.4 | 69.1 |
4. 모델 아키텍처
LLM Backbone
| 구성 요소 | MiMo-V2.6-Pro-RL |
|---|---|
| 레이어(전체 / SWA / GA) | 70 / 60 / 10 |
| 히든 크기 | 6144 |
| SWA 헤드(Q/KV) | 128 / 8 |
| GA 헤드(Q/KV) | 128 / 8 |
| 헤드 차원(QK / V) | 192 / 128 |
| 슬라이딩 윈도 크기 | 128 |
| 라우팅된 전문가(전체 / 활성화) | 384 / 8 |
| 최대 컨텍스트 길이 | 1M |
| MTP / Speculative Decoder | 5 SWA layers, window 1024 |
첫 번째 Transformer 블록은 dense FFN과 함께 global attention을 사용합니다. 나머지 블록은 local SWA와 GA를 교차 배치하며, 둘 다 공유 전문가가 없는 sparse MoE FFN을 사용합니다.
Vision Encoder (MiMo ViT)
| 구성 | 값 |
|---|---|
| 레이어 수(총 / SWA / GA) | 28 / 24 / 4 |
| 은닉 크기 | 1280 |
| 어텐션 헤드 수(Q / KV) | 32 / 8 |
| 헤드 차원 | 64 |
| 패치 크기(T × H × W) | 2 × 16 × 16 |
| 슬라이딩 윈도우(왼쪽 / 오른쪽) | 64 / 64 |
| 공간 병합 크기 | 2 × 2 |
| 파라미터 수 | 681M |
Audio Encoders
AudioTokenizer 인코더: 24개 레이어(12 SWA / 12 GA), hidden 1024, 20개의 RVQ codebook, 308M 파라미터. 오디오 패치 인코더: 6개 레이어, 127M 파라미터; 패치당 4개 프레임(25 Hz → 6.25 Hz).
Speculative Decoder
5개 레이어의 SWA MTP drafter(DFlash 스타일). 병렬 검증을 위해 forward pass당 뒤따르는 7개 토큰을 예측합니다.
5. 배포
최상의 성능을 위해 SGLang MiMo cookbook을 따르세요. Docker image: lmsysorg/sglang:latest.
SGLang
sglang serve \
--trust-remote-code \
--model-path XiaomiMiMo/MiMo-V2.6-Pro-RL \
--tp 16 \
--dp 2 \
--enable-dp-attention \
--mm-enable-dp-encoder \
--ep 16 \
--moe-a2a-backend deepep \
--moe-dense-tp-size 1 \
--mem-fraction-static 0.7 \
--max-running-requests 128 \
--chunked-prefill-size 32768 \
--page-size 64 \
--swa-full-tokens-ratio 0.3 \
--speculative-algorithm EAGLE \
--speculative-num-steps 3 \
--speculative-eagle-topk 1 \
--speculative-num-draft-tokens 4 \
--enable-multi-layer-eagle \
--reasoning-parser mimo \
--tool-call-parser mimo \
--host 0.0.0.0 \
--port 30000 \
--nnodes 2 \
--node-rank <node-rank> \
--dist-init-addr <node0-ip>:20000vLLM
vLLM MiMo-V2.5 레시피를 따르세요. 사전 빌드된 이미지는 docker pull vllm/vllm-openai:mimov25-cu129입니다.
vllm serve XiaomiMiMo/MiMo-V2.6-Pro-RL \
--tensor-parallel-size 8 \
--trust-remote-code \
--gpu-memory-utilization 0.95 \
--max-model-len auto \
--reasoning-parser mimo \
--tool-call-parser mimo \
--enable-auto-tool-choice \
--generation-config vllm권장 샘플링: temperature=1.0, top_p=0.95.
또한 AI Studio, MiMo Code, Xiaomi MiMo Desktop, Xiaomi MiMo Open Platform API, OpenRouter에서도 사용할 수 있습니다.
인용
@misc{mimo2026v26pro,
title={MiMo-V2.6-Pro-RL},
author={{Xiaomi MiMo Team}},
year={2026},
howpublished={\url{https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL}},
}연락처
질문이나 의견이 있으면 mimo@xiaomi.com으로 연락해 주시거나, 커뮤니티에 참여해 주세요:
출처
- 원문: https://huggingface.co/XiaomiMiMo/MiMo-V2.6-Pro-RL (2026-10-22 · huggingface.co)