
OpenAI의 FDE(현장 배치 엔지니어링) 의미
좋아요 · 후기 쓰기
이 글의 목차 · 4개 항목
OpenAI의 FDE 의미와 배포 격차 해소
2026년 10월 22일
Codex가 출시됐을 때 팀의 누군가가 제게 이렇게 물었습니다. “우리가 지난 몇 달 동안 구축해 온 사용 사례를 Codex가 그냥 한 번에 처리할 수 있다면, 우리는 이제 뭘 해야 하죠?”
이 질문은 OpenAI에서 FDE가 의미하는 바의 핵심을 정확히 짚습니다. 우리는 고객과 함께 일하면서 가장 어려운 문제를 이해하고, 그들이 믿고 의지할 수 있는 해결책을 만듭니다. 우리가 배우는 것은 제품의 방향을 형성하는 데 도움이 되고, Research가 해결해야 할 구체적인 문제를 제공합니다.
그것이 진전입니다. 우리가 몇 달마다 우리 스스로를 쓸모없게 만든다면, 우리의 FDE 팀은 제 역할을 하고 있는 것입니다.
저는 2025년 초에 이 팀을 설립해 우리가 “배포 격차(deployment gap)”라고 부르는 것을 좁히고자 했습니다. 즉, 모델이 겉보기에는 할 수 있어 보이는 일과 사람들이 실제로 안정적으로 업무에 사용할 수 있는 것 사이의 거리입니다.
모델의 성능은 그것을 실제로 활용하는 데 필요한 시스템과 프로세스보다 더 빠르게 발전해 왔습니다. 때로는 빠진 것이 제품 하나일 뿐입니다. 때로는 모델이 벤치마크에서는 잘 작동하지만, 실제 환경의 변수와 제약 속에서는 일을 해내지 못하기도 합니다.
우리는 고객의 가장 어려운 문제에 집중합니다. 우리 모델이 오늘 당장 그 일을 해낼 수 있는 경우에는 Product 및 고객과 협력해 그 해결책을 반복 가능하게 만들고, 부족한 부분이 있을 때에는 고객 및 Research와 함께 그 격차를 정의하고 개선합니다. 우리의 목표는 각 협업이 다음 고객에게 더 나은 출발점을 남기도록 하는 것입니다. 다음번에 같은 종류의 문제를 해결할 때 고객이 FDE의 도움 없이도 해결할 수 있을 정도로 기준선을 끌어올린다면, 우리는 제 역할을 잘한 것입니다.
하지만 문제는 종종 완전히 열려 있고, 확립된 정답이 없으며, 정해진 절차도 없습니다. 모두가 한 번도 존재하지 않았던 무언가를 만들고 싶어 합니다. 그런데 그곳에 도달하기 위해 필요한 일을 하려는 사람은 훨씬 적습니다.
“충분히 괜찮은” 수준의 기준을 끌어올리면서도 재능 있는 FDE를 찾는 일은, 끊임없는 실험과 실행을 의미했습니다.
모든 FDE 팀 세션의 시작마다 저는 핵심 가치가 적힌 슬라이드를 띄웁니다. “결과부터 시작하고, 성공하기 위해 필요한 일을 한 다음, 확장하라.”
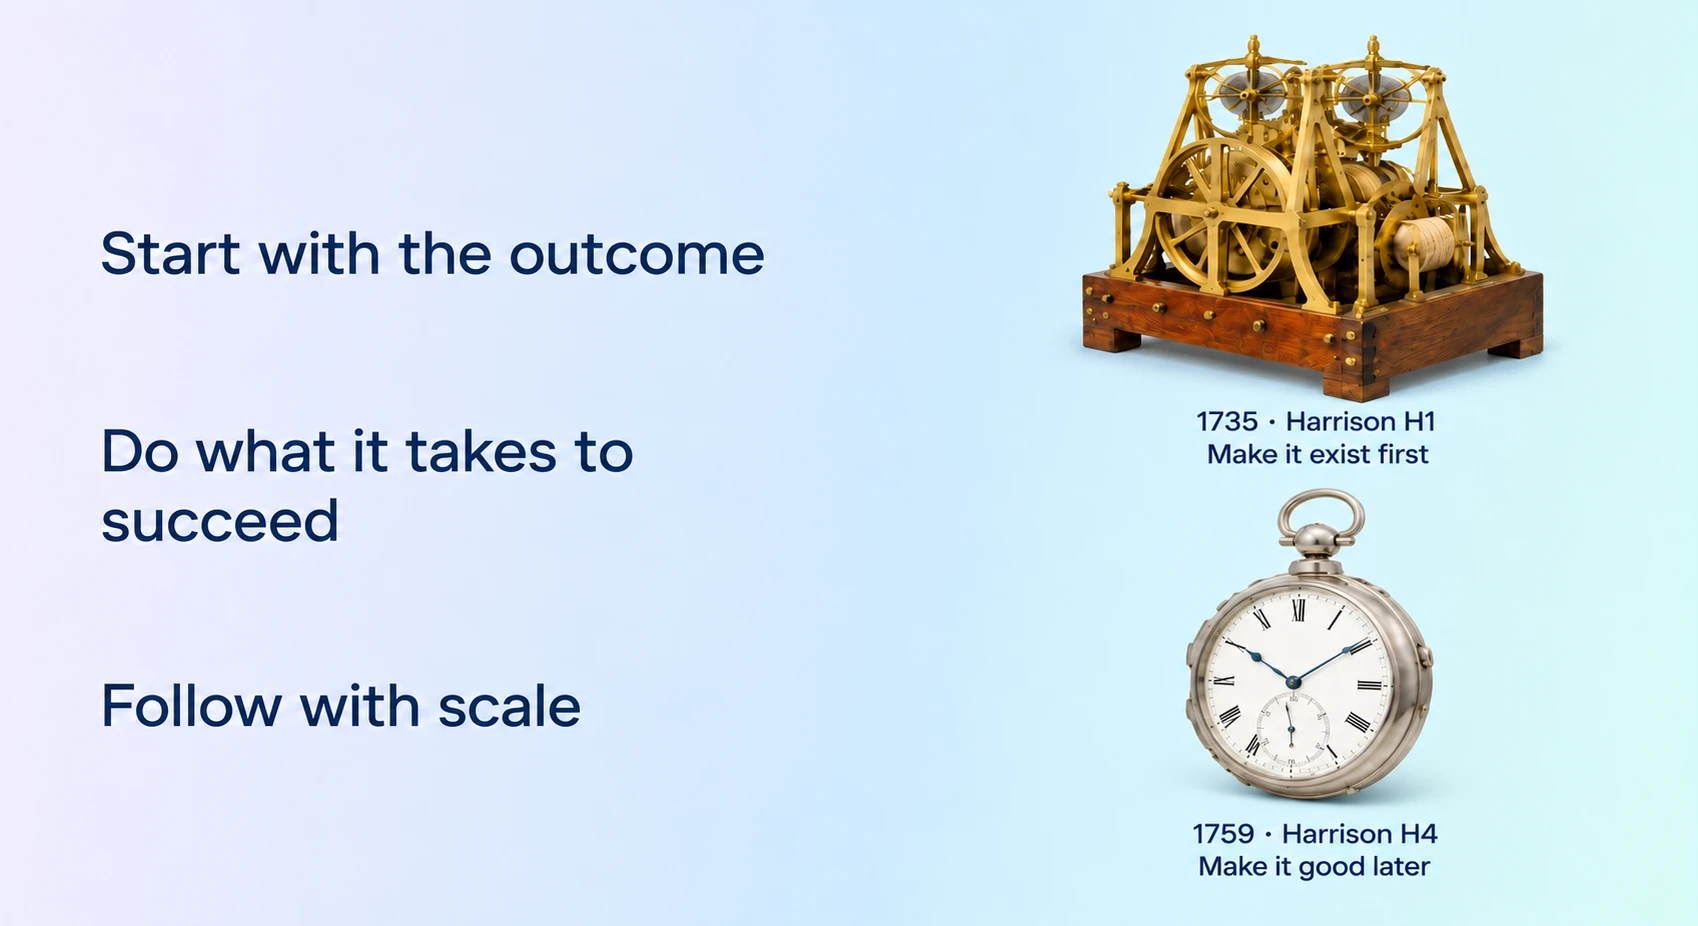
인상적인 데모는 아무도 그것이 실제 세계에서 제대로 작동하는지 묻기 전까지는 큰 영향을 줄 수 있습니다.
우리의 일은 고객의 문제를, 운영 환경에서 우리가 책임질 수 있는 수준으로 해결하는 것입니다.
우리 FDE는 첫날부터 그 산업을 모두 알 필요는 없지만, 그것을 배우는 것은 FDE의 책임입니다.
코딩 어시스턴트가 소프트웨어를 더 빠르게 만들수록, 고객의 비즈니스를 이해하는 일은 더욱 중요해집니다. 우리는 제너럴리스트와 도메인 전문가를 섞은 팀을 만듭니다.
합리적인 판단을 내릴 만큼의 지식이 필요하고, 현상 유지에 대한 가정을 의심할 만큼의 호기심도 필요합니다.
예를 들어 생명과학 분야에서, 우리 FDE의 과학적 배경은 표적 검증과 우선순위 지정, 유전자 발현 분석, 화학 합성 경로 재구성 같은 전임상 약물 발견 업무를 수행하는 연구자들과 신뢰를 쌓는 데 도움이 됩니다. 그런 전문성 덕분에 이 워크플로가 어떻게 개선될 수 있는지에 대해 근거 있는 판단을 제공할 수 있습니다.
우리는 이런 워크플로가 가치를 낼 수 있다는 것을 보여 주었지만, 여전히 다른 팀으로 확장하려면 너무 많은 맞춤형 통합이 필요했습니다. 다음 과제는 그 결과를 유지하면서도 소프트웨어를 더 쉽게 배포하고 유지보수할 수 있게 만드는 것이었습니다.
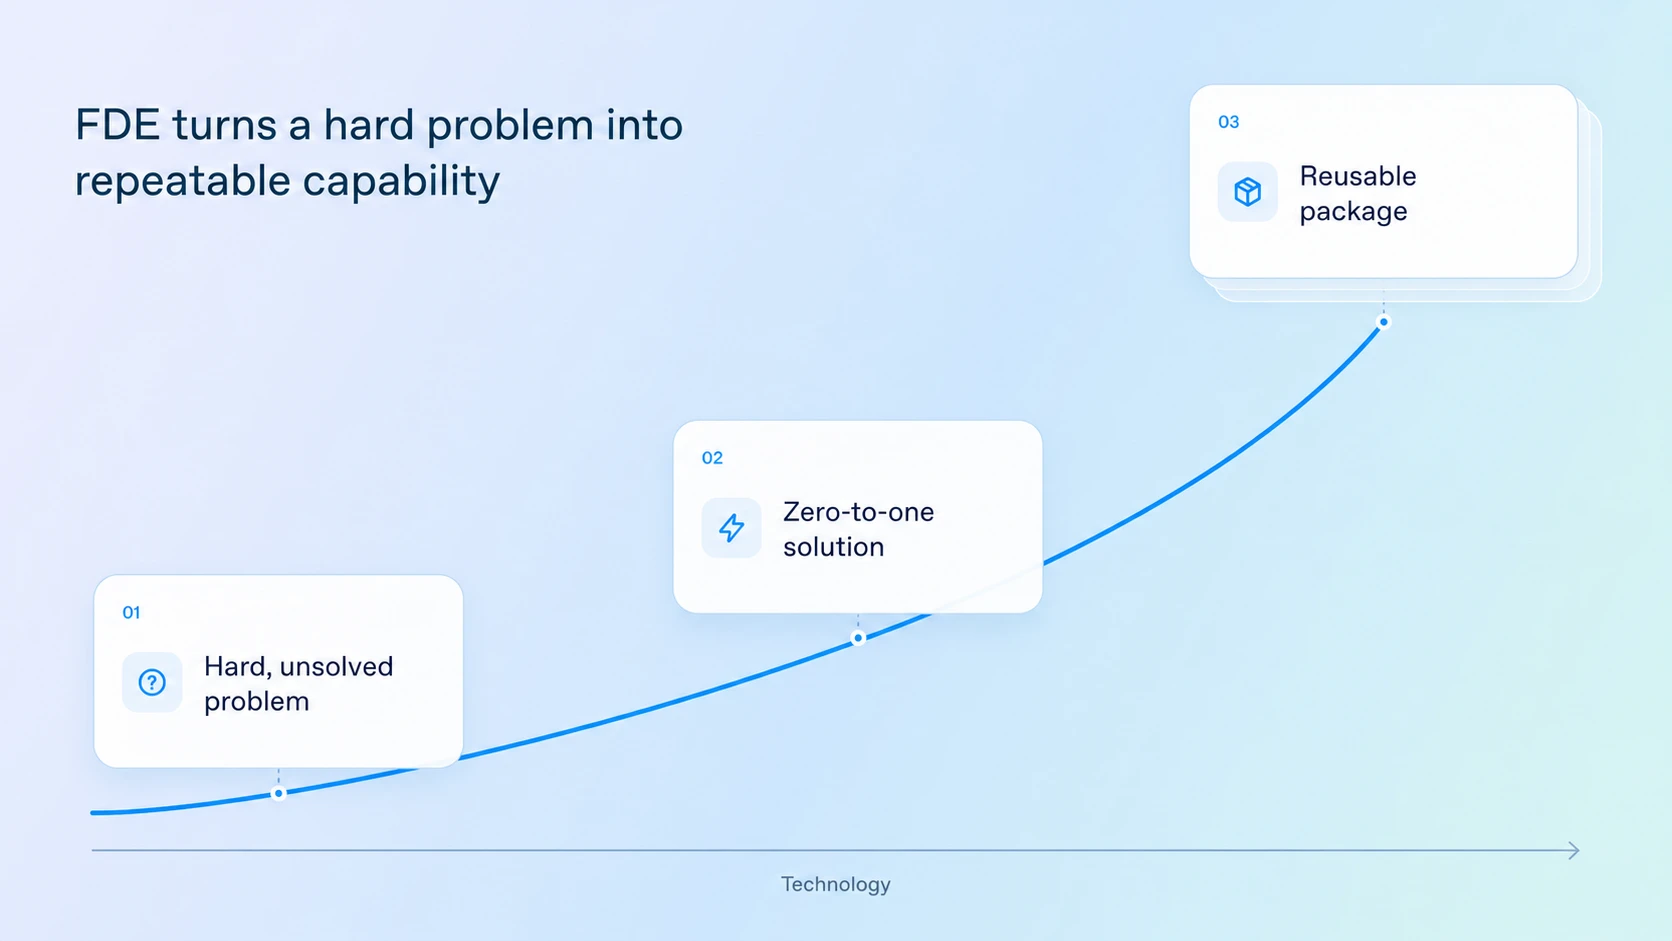
그 무렵 Codex의 성능은 더 향상되어 있었습니다. 한 FDE는 이를 기반으로 애플리케이션을 다시 만드는 실험을 했고, 이후 팀과 함께 사용 사례들을 Codex를 핵심으로 하는 공통 하니스로 옮겼습니다.
맞춤형 애플리케이션은 공통 Codex 프리미티브 위에 구축된 플러그인과 스킬이 되었습니다. Codex는 또한 인터페이스가 되어, 개별 사용 사례를 위해 따로 작성했던 터미널 UI와 CLI를 없앨 수 있게 해 주었습니다.
프로젝트마다 맞춤 코드를 대략 90% 제거할 수 있었고, 이것은 우리가 이 워크플로를 구축하고, 유지하고, 확장하는 방식을 바꾸어 놓았습니다:
- Codex에 대한 중앙 집중식 개선의 혜택을 받을 수 있어, 각 개별 사용 사례마다 필요한 접착성 코드의 양을 줄일 수 있었습니다
- 핵심 기능들은 skill과 plugin으로 묶여 있어 서로 더 쉽게 공유할 수 있었고, AI CoE가 중앙에서 제어하기도 쉬웠습니다. 이는 한 팀에서 다음 팀으로 확장하는 일이 새 connector/MCP server로 교체하고, 새 evals를 만들고(이것도 저희에게는 하나의 skill이 있었습니다), 바로 가동하는 것만큼 단순할 수 있었음을 뜻했습니다.
- 2026년 8월의 한 사례에서는 초기 배포에 두 달이 걸렸습니다. 해결책을 두 번째 팀에 확장하는 데는 하루가 걸렸습니다. 이후 팀들은 확장하면서 더 빠르게 온보딩되었습니다. 이것은 계속 이어져 왔고, 2026년 8월의 한 사용 사례에서는 초기 배포에 2개월이 걸렸지만 두 번째 팀은 1일 만에 적용할 수 있었습니다.
그것이 우리를 쓸모없게 만드는 한 가지 방식입니다. 프로덕션에 도달하기 위해 해온 작업은 무엇이 중요한지 드러냈습니다. 기반 제품이 개선되면서, 우리는 맞춤 구현의 많은 부분을 대체하고 그것이 제공하던 가치는 유지할 수 있었습니다.
이것이 바로 순서가 중요한 이유입니다. LLM은 우리가 빠르게 만들 수 있게 해줍니다. 그 속도를 활용해 사용자 손에 가치 있는 무언가를 빠르게 전달하고, 실제 환경에서 무엇이 효과적인지 배우고, 그런 다음 작동하는 것을 확장하세요.
같은 원칙은 모든 협업에 적용됩니다.
때로는 더 나은 제품이 우리가 만든 것을 단순화해 주지만, 때로는 모델 자체가 아직 그 일을 해내지 못하기도 합니다.
오늘날의 모델이 이미 가능하게 해 주는 것만 만든다면, Research가 다음 단계에서 해결해야 할 지능의 간극을 발견하지 못할 것입니다. 따라서 저희의 중요한 많은 협업은 고객, FDE, Research가 그 한계를 함께 넘어서기 위해 힘을 모으는 지점에서 시작합니다.
각 요소가 중요했습니다. 고객은 모델이 아직 풀지 못하는 문제를 함께 해결하겠다고 약속했습니다. FDE는 그 문제를 정의하고 플랫폼을 구축하며 협업을 처음부터 끝까지 이끌 수 있을 만큼 가까이 붙어 있었습니다. Research는 기반 모델의 역량을 개선했습니다.
이것이 우리를 쓸모없게 만드는 또 다른 방식입니다. 오늘날의 모델로는 풀 수 없는 문제를 미래의 모델이 제공할 수 있는 역량으로 바꾸는 데 도움을 주는 것입니다. 우리가 하는 일의 가치는 한 고객과 함께 보내는 시간 이상으로 확장됩니다.
저는 사람들이 일상 업무에서 AI를 유용하게 쓰도록 만드는 데 도움을 주고 싶어서 OpenAI에 합류했습니다. 그 점은 여전히 팀을 이끄는 기준입니다. 저는 팀에 자주 말합니다. LLM 개발에서는 대부분의 경우 오컴의 면도날이 적용된다고 말이죠. 가장 단순한 해결책이 최고의 해결책입니다. 최첨단 연구로 정의되는 회사이자 과장된 표현으로 얼룩진 업계에서, 우리는 현장의 사람들이 신뢰하고 의지할 수 있는, 안정적으로 작동하는 것을 만들고자 합니다.
목표는 각 협업이 다음 성과를 더 좋게 만드는 것입니다. 배포하기 더 쉬운 제품, 더 어려운 작업을 처리할 수 있는 모델, 또는 다음 고객을 위한 더 적은 맞춤 작업입니다.
해결하고 싶은 어려운 문제가 있다면, 저희와 함께 일하고 싶습니다. 그 문제를 푸는 데 도움을 주고 싶다면, 저희와 함께해 주셨으면 합니다.
그렇다면 Codex가 우리가 수개월에 걸쳐 만든 일을 해낼 수 있을 때 우리는 무엇을 할까요?
더 어려운 문제를 찾으러 가십시오.
Author
Colin Jarvis
계속 읽기
출처
- 원문: https://openai.com/index/forward-deployed-engineering-means (2026-10-22 · openai.com)
자료 표지 보기
